Tag
#agentops
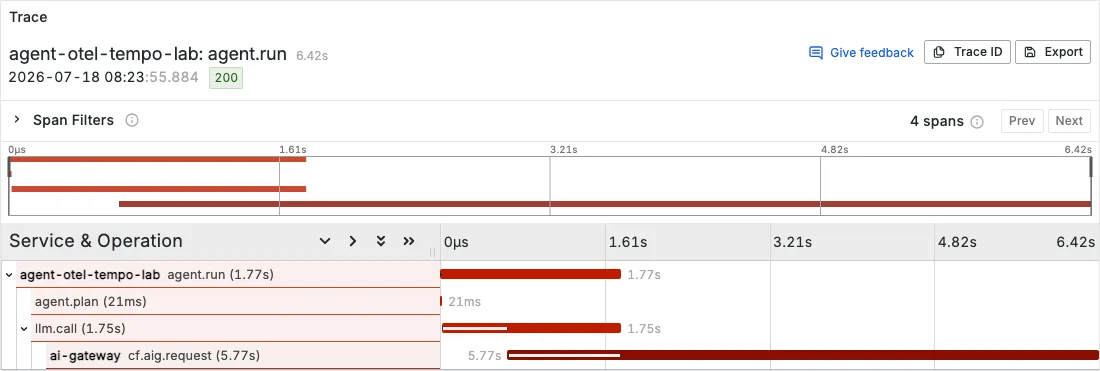
Cloudflare AI GatewayのOTel spanをGrafana Tempoで追う。正常応答のspanは届いたが、エラー時のspanは届かなかった
Cloudflare AI GatewayとNode.js AgentのOpenTelemetry spanを同じtrace IDでGrafana Tempoへ送り、正常応答、クライアントタイムアウト、モデル指定エラー、フォールバックを比較した。Tempoに届いた正常応答spanと届かなかったエラーspan、アプリ・Gatewayログ・OTel spanのduration差、回答品質に別の観測点が必要な理由を整理する。
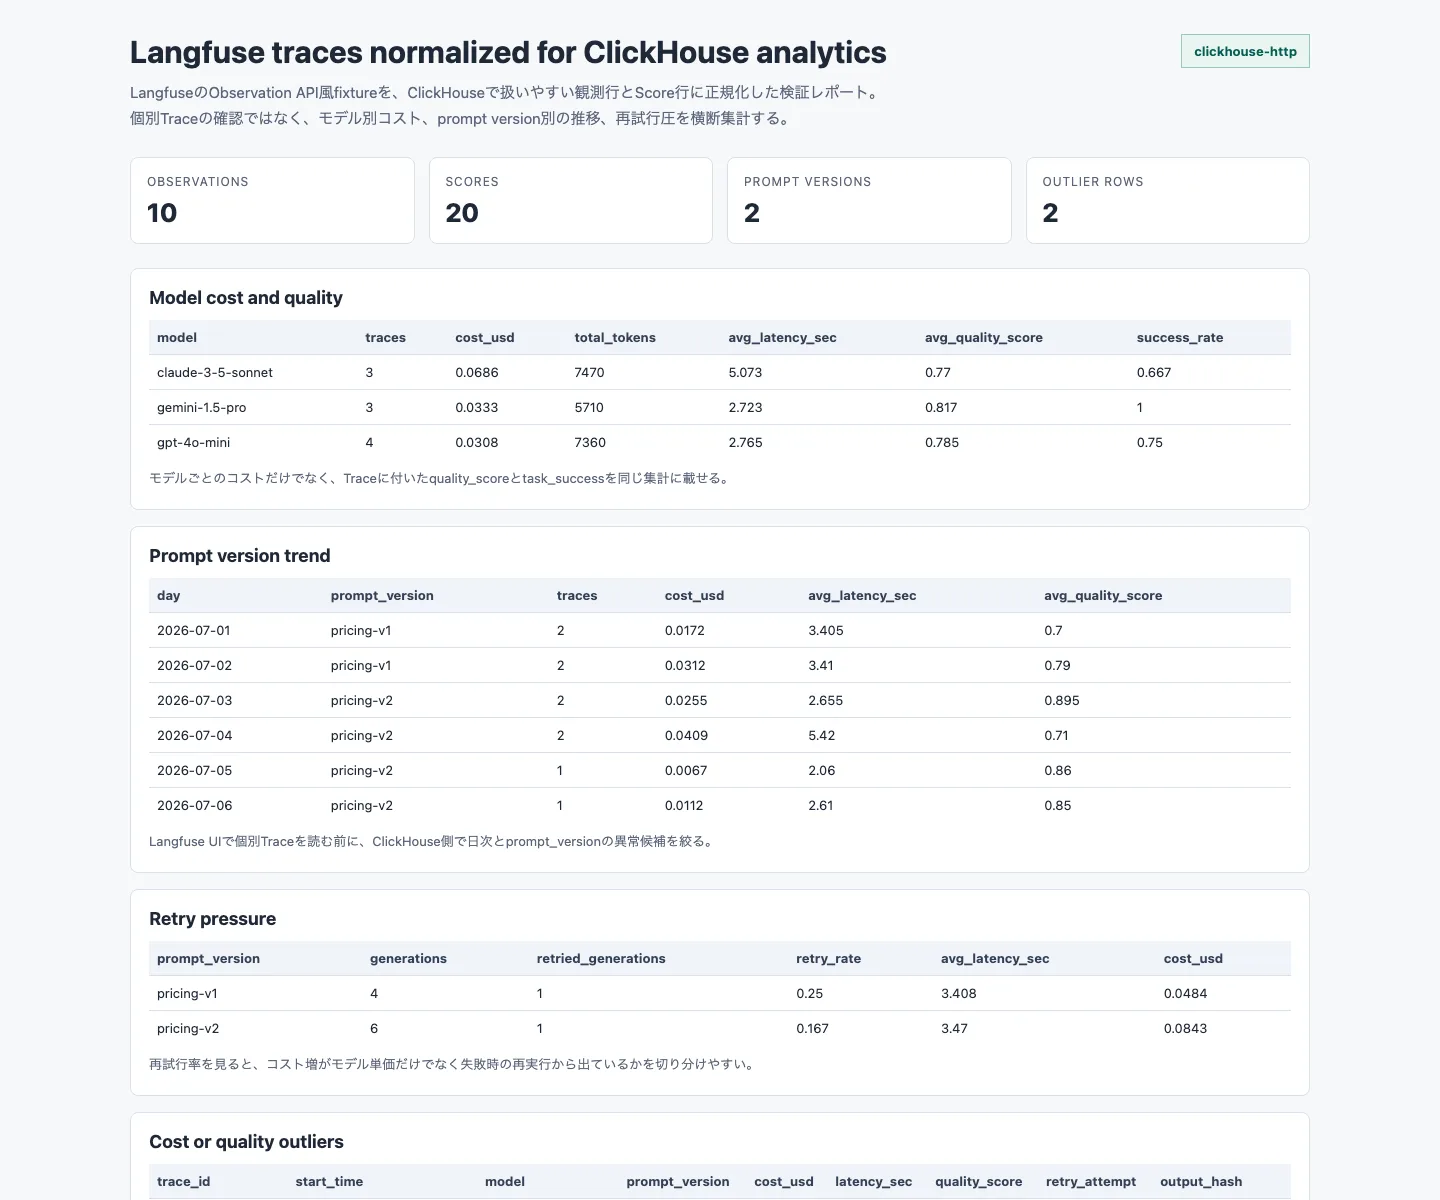
LangfuseのLLMトレースをClickHouseで長期分析する
LangfuseのObservationとScoreをClickHouseへ正規化し、モデル別コスト、prompt version別の品質推移、再試行によるコスト増をSQLで確認する検証ログ。
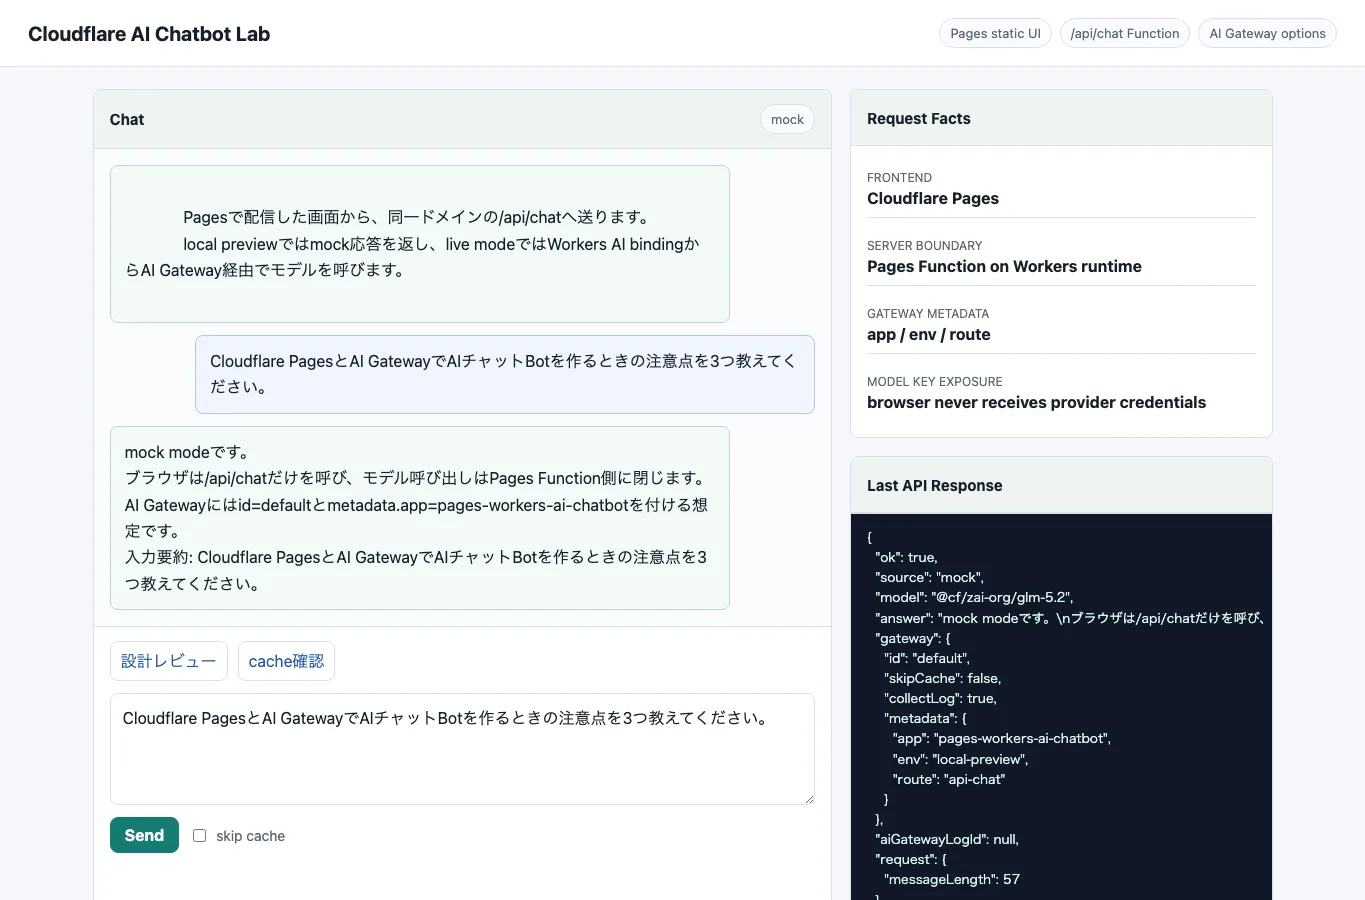
Cloudflare PagesとWorkersとAI GatewayでAIチャットBotの土台を作る
Cloudflare Pagesの静的UI、Pages Function、Workers AI binding、AI Gatewayを組み合わせ、ブラウザにAPIキーを出さないAIチャットBotの最小構成を検証する。
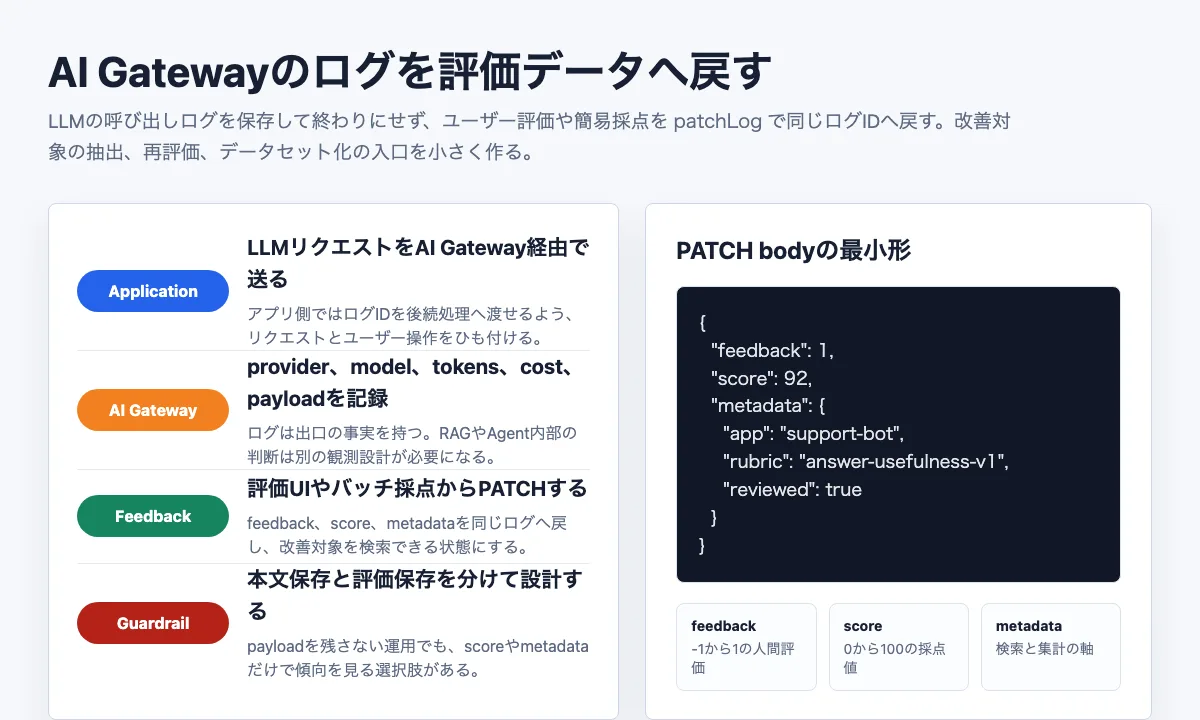
Cloudflare AI GatewayのpatchLogでLLMの評価ログを育てる
AI Gatewayのログにfeedback、score、metadataを後付けし、LLMのリクエストログを改善対象の評価データへ変えるための小さな検証メモ。
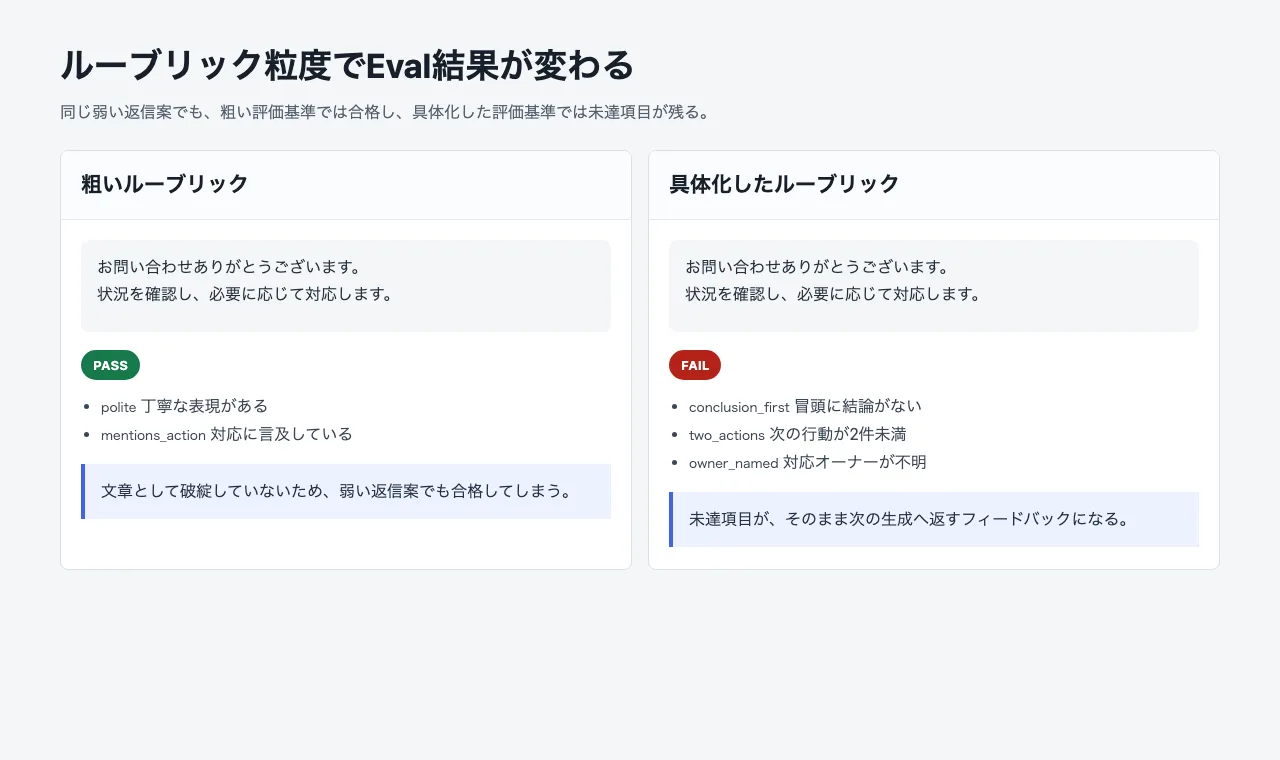
ルーブリックとEvalは最初から正しく作れないので、失敗ログで育てる
LLMの出力改善ループで、評価基準が粗いままだと弱い出力が合格してしまう問題を、外部APIに依存しない検証スクリプトで確認します。ルーブリックを運用しながら育てるための判断軸を整理しました。
Langfuse Assistantは運用調査の入口になるかをAPIの正解データで検証する
Langfuse AssistantのPublic Betaを、既存のSakana Fugu観測データとPublic APIから計算した正解値で検証します。
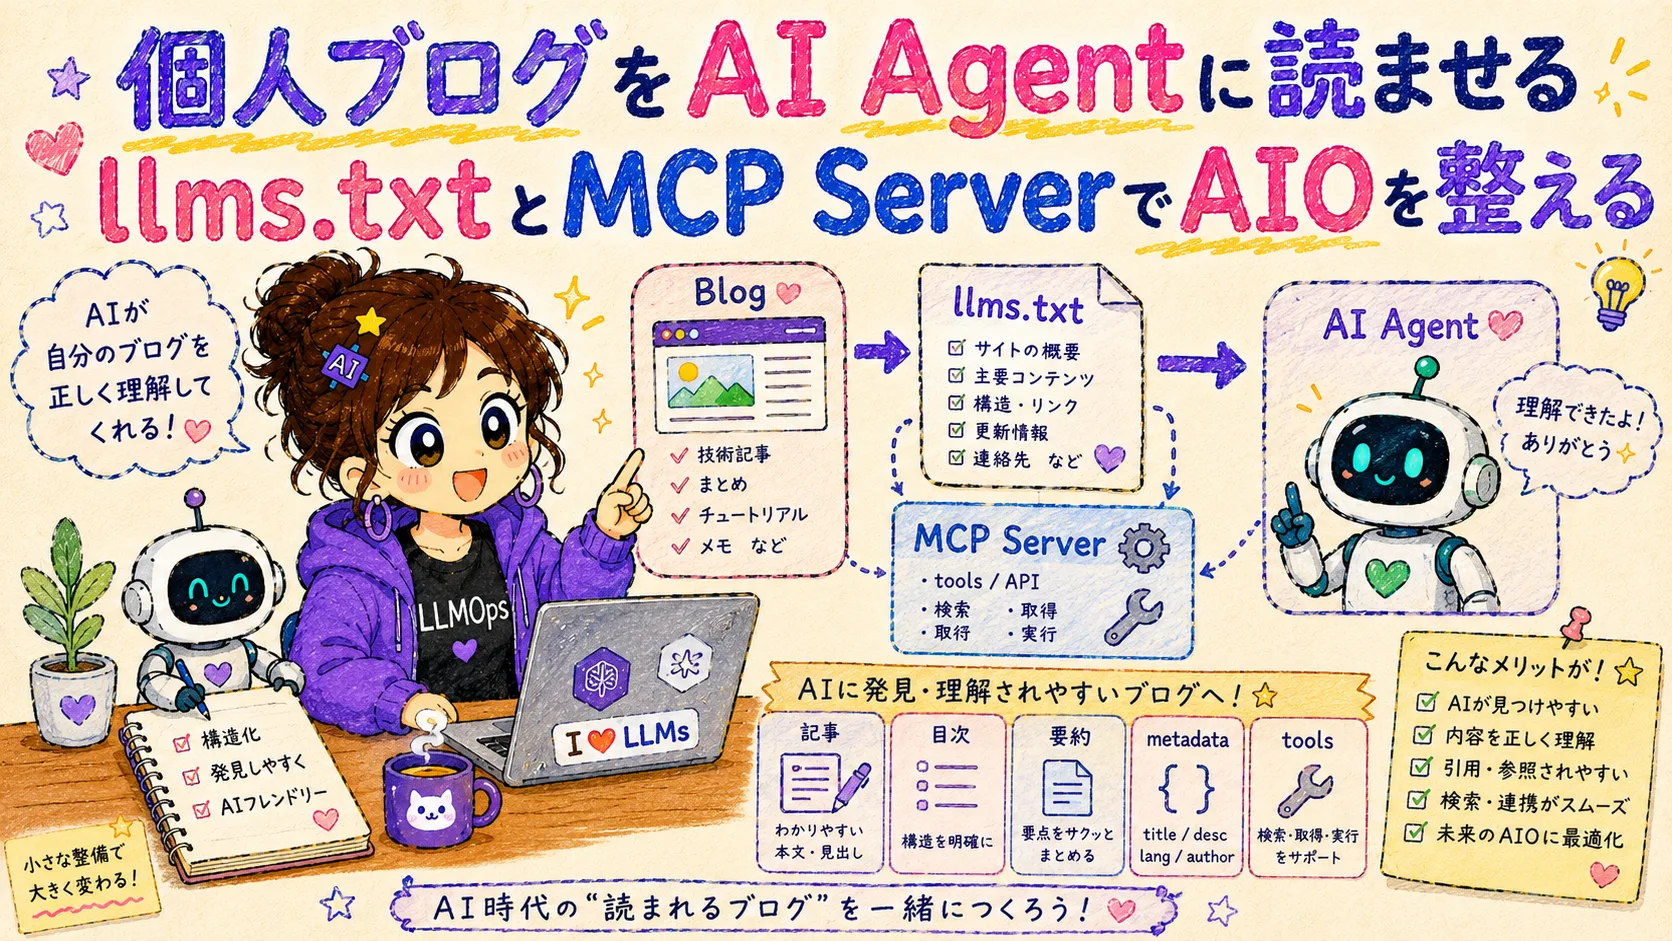
個人ブログをAI Agentに読ませる llms.txtとMCP ServerでAIOを整える
PerplexityやChatGPTが検索の代わりになる中、個人ブログをAI Agentからも発見可能にするAIO(AI最適化)の実装。llms.txt、JSON API、MCP Serverの3層設計と、46本規模での採用判断基準。
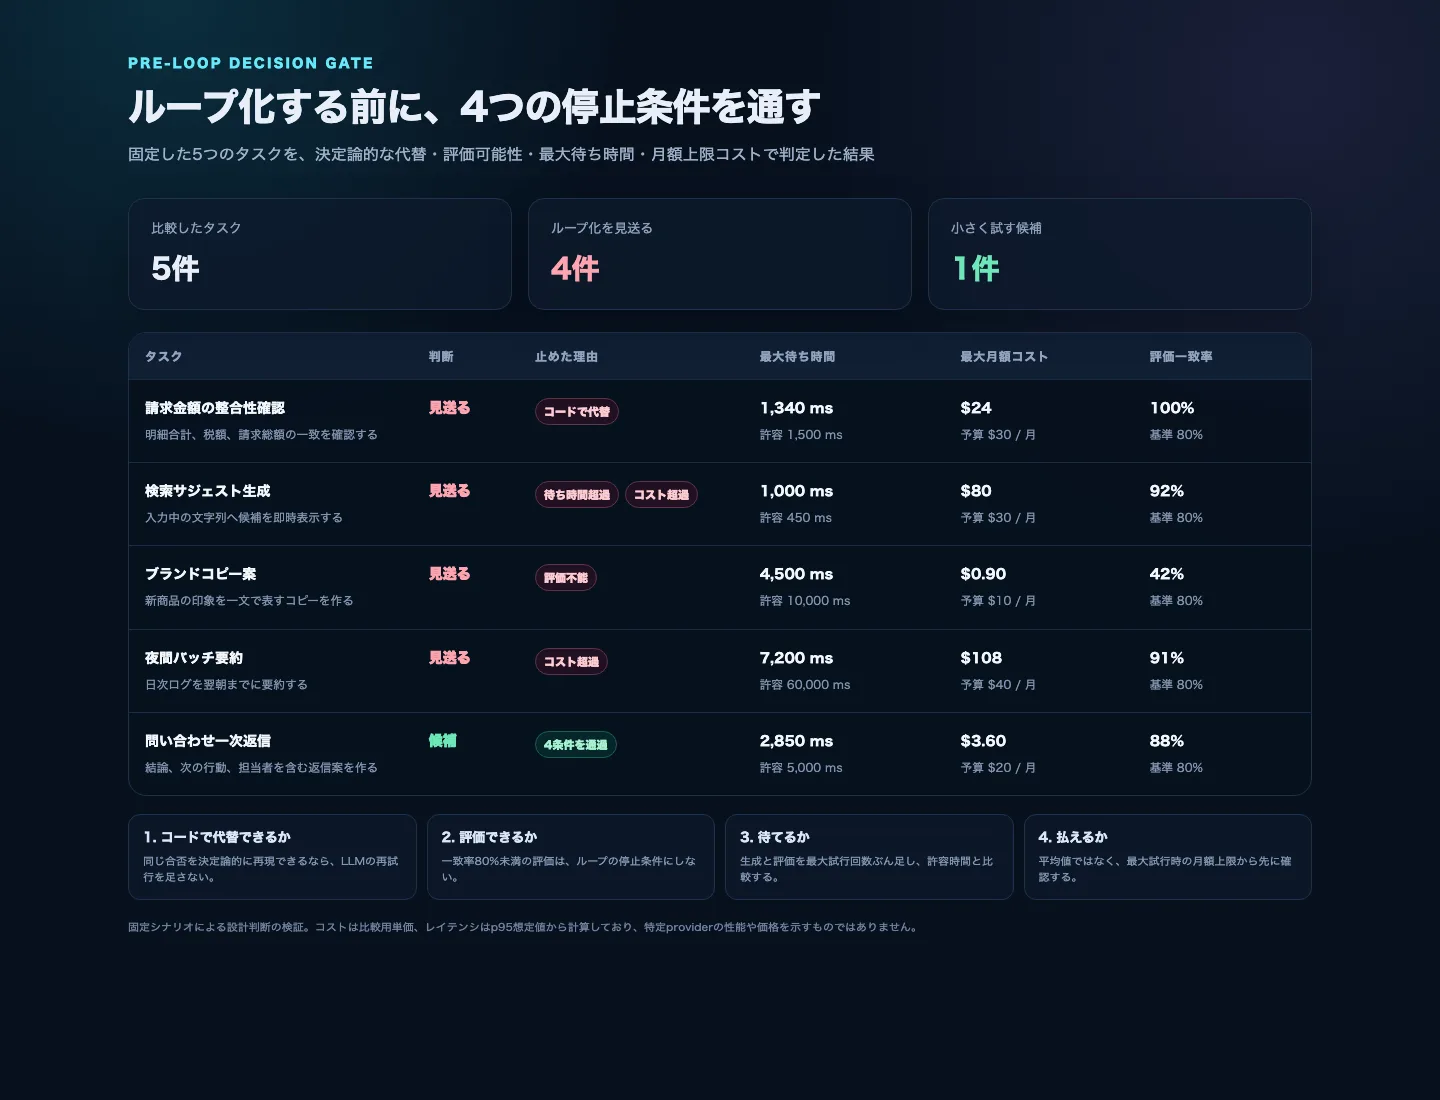
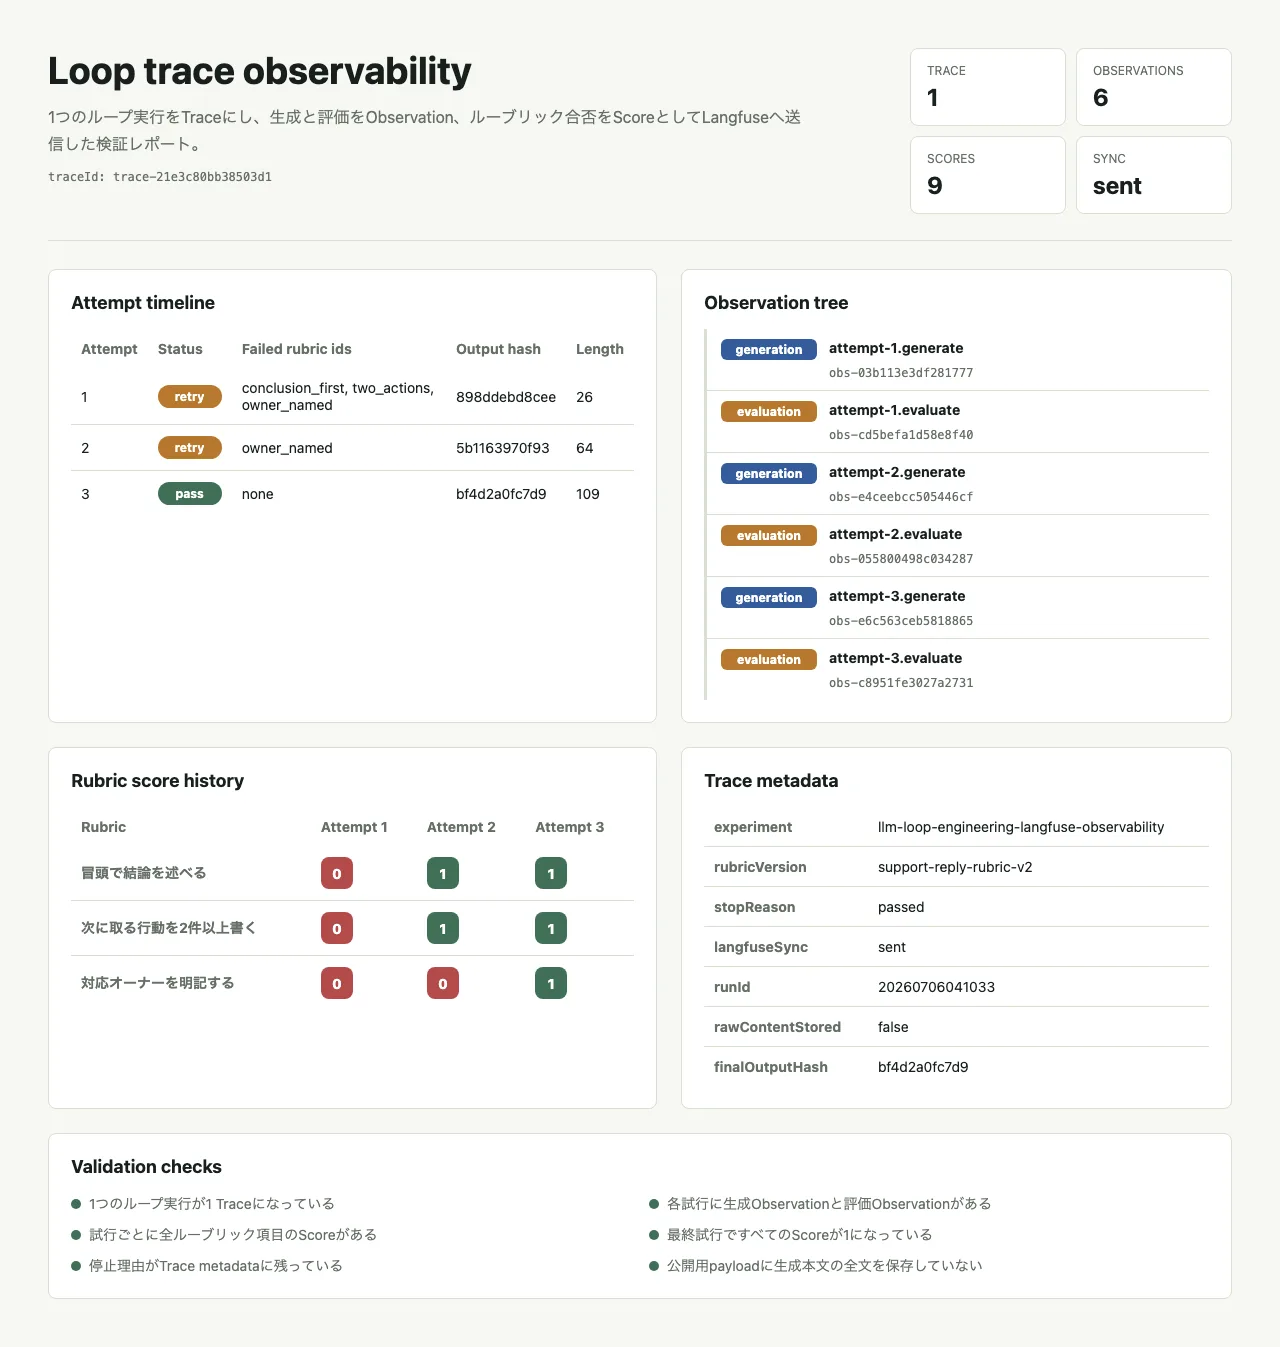
APIで最小ループを組むと、プロンプト改善ではなく停止条件の設計になる
生成、評価、フィードバック、再生成を分けた最小ループを検証用スクリプトで実装し、AI出力を安定させるときに見るべき停止条件と評価単位を整理します。
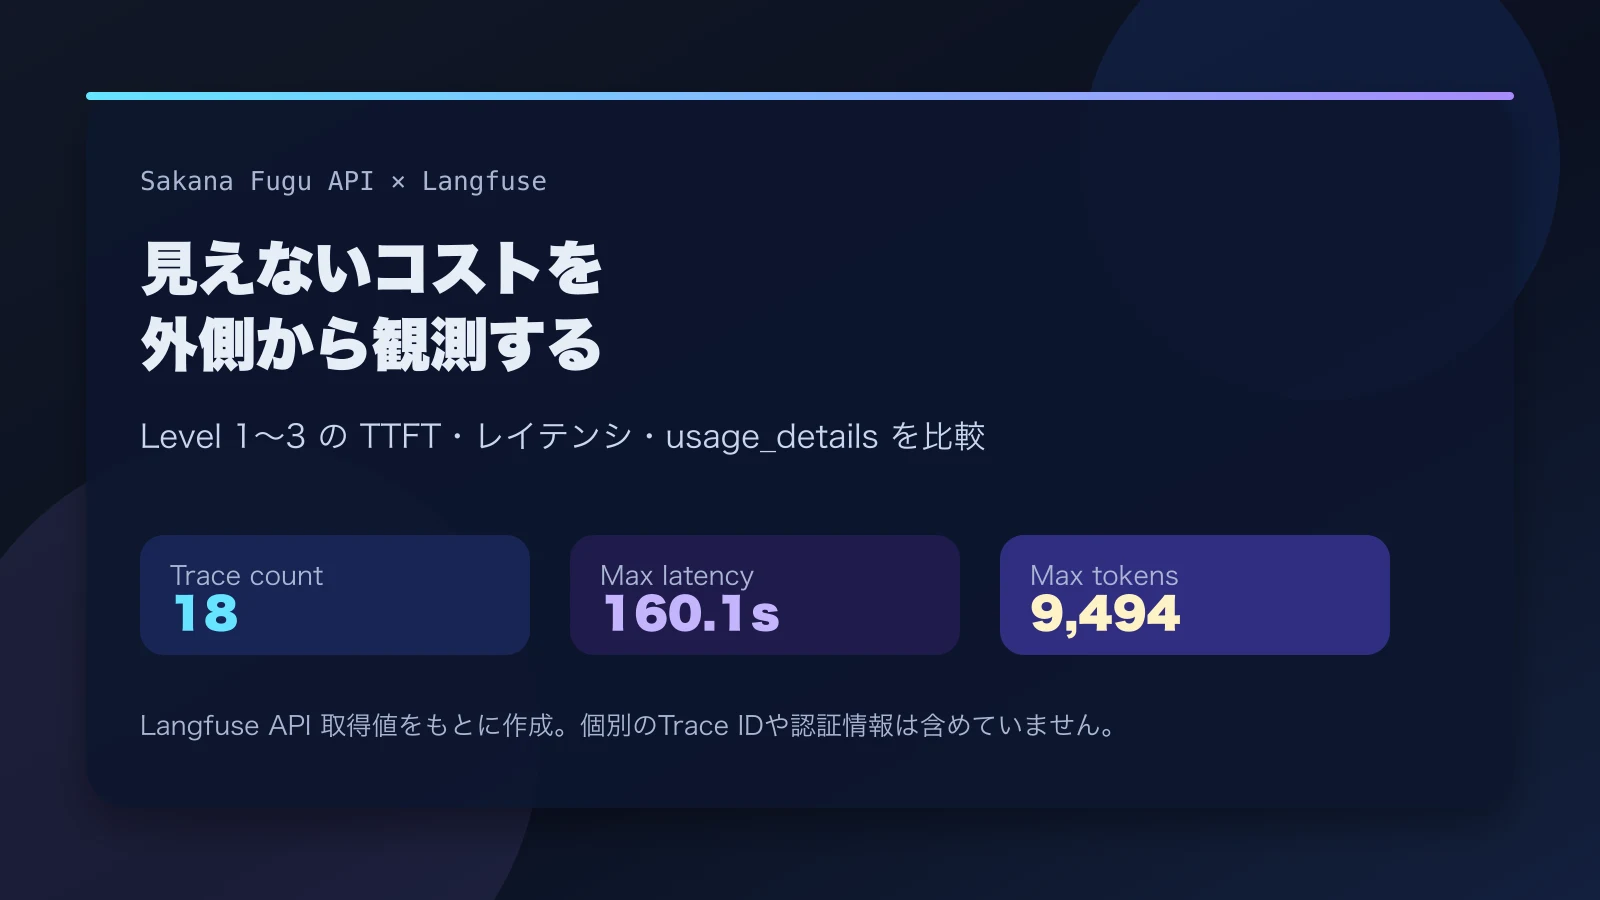
Sakana Fugu APIをLangfuseで観測し、マルチエージェントの見えないコストを考える
Sakana FuguのOpenAI互換APIをLangfuseで計装し、Level 1〜3のタスクでレイテンシ、消費トークン、TTFTがどう変化するかを観測した実践レポート。
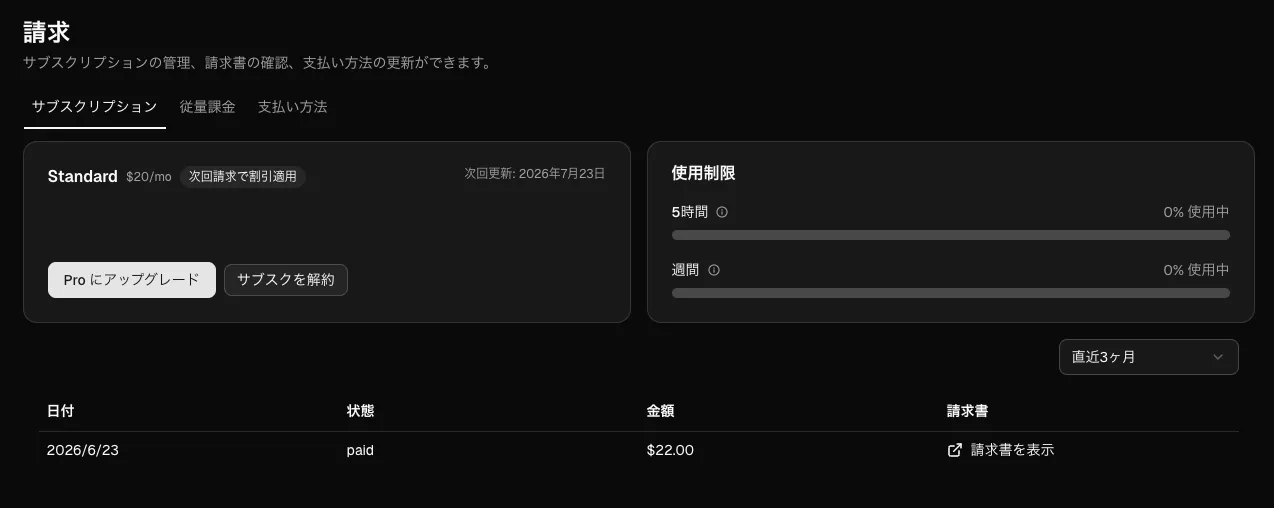
Sakana Fuguを契約したので、マルチエージェントAPIの見えなさをLangfuseで観測する
Sakana Fuguをサブスク契約して分かったOpenAI互換APIとしての性質と、ブラックボックスな協調推論を外側から観測するための検証計画。