Cloudflare AI GatewayのOTel spanをGrafana Tempoで追う。正常応答のspanは届いたが、エラー時のspanは届かなかった
Cloudflare AI GatewayとNode.js AgentのOpenTelemetry spanを同じtrace IDでGrafana Tempoへ送り、正常応答、クライアントタイムアウト、モデル指定エラー、フォールバックを比較した。Tempoに届いた正常応答spanと届かなかったエラーspan、アプリ・Gatewayログ・OTel spanのduration差、回答品質に別の観測点が必要な理由を整理する。
AI Gatewayログだけでは追えないAgent全体の待ち時間をTempoで確認する
以前の検証では、Cloudflare AI Gatewayのログにmodel、status、duration、tokens、cost、prompt、responseが残ることを確認しました。LLMの出口で起きたことを調べるには使いやすいログです。
しかし、Agent全体の遅さを説明しようとすると情報が足りません。
LLMを呼ぶ前の計画に何msかかったのか。失敗を受けてフォールバックを決めるまでに何ms止まったのか。ユーザーが待った時間のうち、AI Gatewayの外側はどれくらいだったのか。Gatewayの1リクエストログだけでは、これらを同じ時間軸に並べられません。
そこで、Cloudflare AI Gatewayが出すOTel spanと、アプリ側で作るAgent spanをGrafana Tempoへ集めました。期待したのは、ログを増やすことではなく、処理の因果関係を1本につなぐことです。
実際に試すと、正常系はつながりました。一方、失敗系には穴がありました。しかも、同じLLM呼び出しを測ったはずの3つのdurationが大きくずれました。
このずれが、今回いちばん気になった点です。
Node.js AgentとAI Gatewayのspanを同じtrace IDでTempoへ送る
検証日は2026年7月18日です。Node.js 22の小さなAgentスクリプトから、AI Gateway経由でWorkers AIの@cf/meta/llama-3.1-8b-instruct-fastを呼びました。traceはローカルのGrafana Tempo 2.8.2へ保存し、表示にはGrafana 12.1.0を使っています。
構成は次のとおりです。
Node.js Agent
  ├─ agent.run / agent.plan / llm.call ──OTLP──┐
  │                                             │
  └─ Cloudflare AI Gateway ── Workers AI        ├─ Grafana Tempo
└─ cf.aig.request ──OTLP──認証Proxy───┘CloudflareのAI Gateway OTel連携は、OTLP/JSONまたはOTLP/Protobufの送信先URL、Content-Type、追加ヘッダーを設定できます。ローカルのTempo receiverを直接公開せず、短命なTunnelの手前に認証Proxyを置き、検証用ヘッダーが一致したリクエストだけを/v1/tracesへ中継しました。
入力は固定した短い検証文だけです。API token、Account ID、Tunnel URL、認証ヘッダー値はartifactへ保存していません。検証後は、専用GatewayのOTel exporter設定を元の0件へ戻しました。
Cloudflare指定のHTTPヘッダーでspanの親子関係を渡す
AI Gatewayへ伝えるtrace contextには、Cloudflareが定める2つのHTTPヘッダーを使います。
const headers = {
  "cf-aig-otel-trace-id": traceId,       // 32桁のhex
  "cf-aig-otel-parent-span-id": spanId, // 16桁のhex
};アプリ側ではagent.runをroot spanにし、その子としてllm.callを作ります。llm.callのtrace IDとspan IDを上のヘッダーへ入れると、AI Gatewayのcf.aig.requestがその子spanとしてTempoへ入りました。
ただし、trace contextをそろえただけでは動きませんでした。最初のリクエストは401、Cloudflareのエラーコード10000で止まりました。使っていたAPI tokenにはAI Gateway設定の書き込み権限がありましたが、Workers AIを実行する権限がなかったためです。Gatewayのexporterを設定できる権限と、その先のモデルを呼べる権限は別でした。
正常応答を実行し、AgentとAI Gatewayの4つのspanを確認する
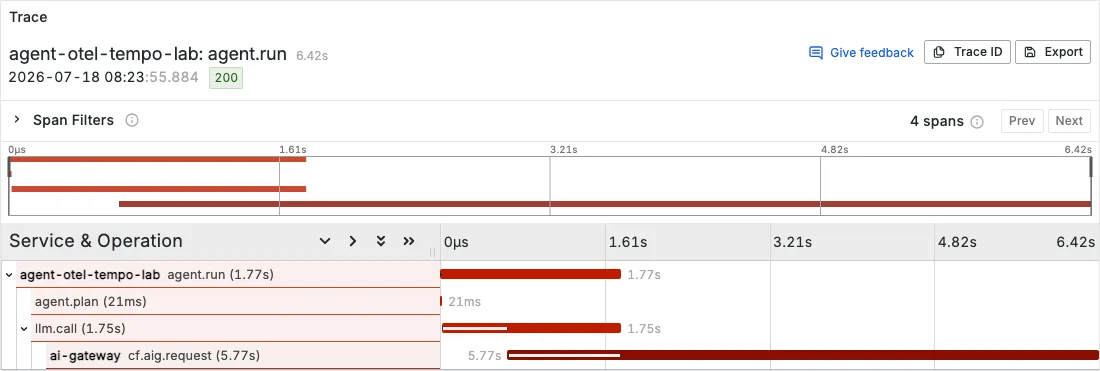
正常応答のtraceには4つのspanが入りました。
agent.run
├─ agent.plan
└─ llm.call
└─ cf.aig.requestagent.runとllm.callはアプリ側、cf.aig.requestはAI Gateway側が送ったspanです。Tempo上でもserviceはagent-otel-tempo-labとai-gatewayに分かれていますが、親子関係は維持されています。
これで、Agentの計画処理、アプリが待ったLLM呼び出し、AI Gatewayが送ったGenAI spanを同じ画面で比較できます。「Agentが遅い」という現象を、少なくとも処理段階へ分解できるようになりました。
ただ、図を見ると別の疑問が出ます。rootのagent.runは1.77秒で終わっているのに、その子に見えるcf.aig.requestは5.77秒あります。親より子の方が長いのです。
タイムアウトとモデル指定エラーを実行し、spanとGatewayログを比較する
同じ構成で、次の2つの失敗ケースを実行しました。
- 300msでクライアント側から中断する
- 存在しないモデルで
400を発生させ、正常なモデルへフォールバックする
結果は次のとおりです。
| ケース | アプリspan | AI Gatewayログ | AI GatewayのOTel span |
|---|---|---|---|
| 正常応答 | 成功として記録 | あり | あり |
| 300msタイムアウト | client-timeoutとして記録 | 見つからず | 見つからず |
| 存在しないモデル | 400 / cloudflare-5007として記録 | あり | 見つからず |
| フォールバック先の正常応答 | 成功として記録 | あり | あり |
タイムアウトは、クライアントが304msで中断した事実をアプリspanに残せました。しかし、同じtrace IDにAI Gateway spanはなく、Gatewayログにも該当リクエストを見つけられませんでした。
存在しないモデルへの呼び出しは少し違います。アプリでは1,877ms後に400を受け、AI Gatewayログにもstatus 400、duration 1,713msの記録がありました。それでもcf.aig.request spanはTempoへ届きませんでした。
その後のフォールバック判断32msと、正常モデルへの2回目の呼び出し364msはアプリspanに残っています。2回目の呼び出しだけは、AI Gateway spanも同じtraceに加わりました。
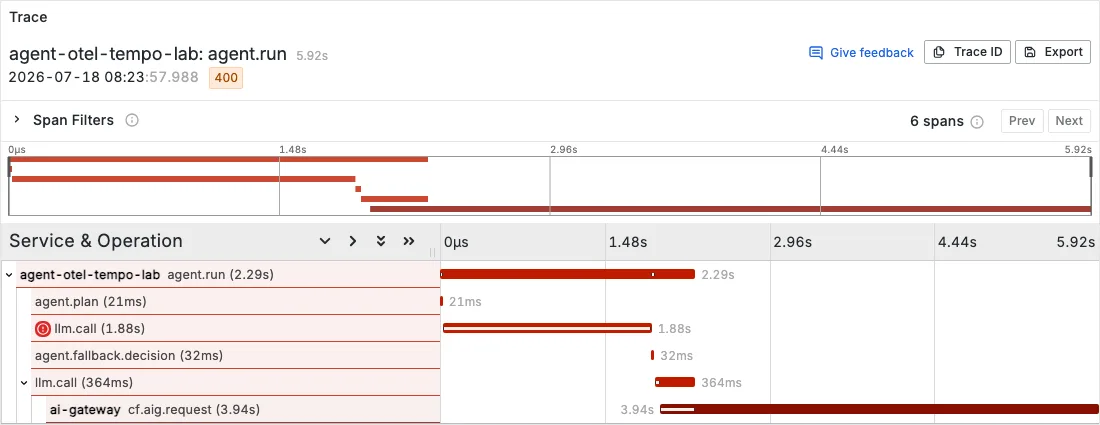
つまり、今回の条件では「AI Gatewayのリクエストログにあること」と「OTel exporterからspanが届くこと」は同義ではありませんでした。Tempoだけをエラー件数の原本にすると、モデル指定エラーを数え落とします。反対にアプリだけを見ても、Gateway内部の属性は分かりません。
失敗を追うなら、アプリspan、AI Gatewayログ、OTel spanの3つを同一視しない方が安全です。
アプリ、Gatewayログ、OTel spanのdurationを比較する
先ほど残った「親より子が長い」という違和感は、3つのdurationを並べるとさらにはっきりしました。
| 呼び出し | アプリのllm.call | AI Gatewayログ | cf.aig.request span |
|---|---|---|---|
| 正常応答 | 1,747ms | 1,088ms | 5,766ms |
| フォールバック先 | 364ms | 302ms | 3,943ms |
アプリのdurationは、HTTPリクエストを開始して応答を読み終えるまでです。AI Gatewayログのdurationはそれより短く、OTel spanはアプリが応答を受け取った後まで続いていました。
この1回の検証だけで、Cloudflare内部のどの処理が差分を作ったかは断定できません。export処理のタイミングや、それぞれの計測境界が異なる可能性があります。ただし、少なくともcf.aig.requestのdurationを、そのままユーザーの待ち時間として扱えないことは確認できました。
ユーザー体感に近いSLOはアプリ側spanで測り、AI Gateway spanはGateway内部の処理やGenAI属性を見るものとして分ける方が自然です。
AI Gateway spanのGenAI属性と含まれない評価情報を確認する
durationをユーザーの待ち時間として扱えなくても、AI Gateway spanには別の情報があります。今回届いたのは、次のGenAI属性です。
gen_ai.operation.namegen_ai.request.modelgen_ai.provider.namegen_ai.usage.input_tokensgen_ai.usage.output_tokensgen_ai.usage.costgen_ai.input.messagesgen_ai.output.messages- exporterへ渡した
app、env、case
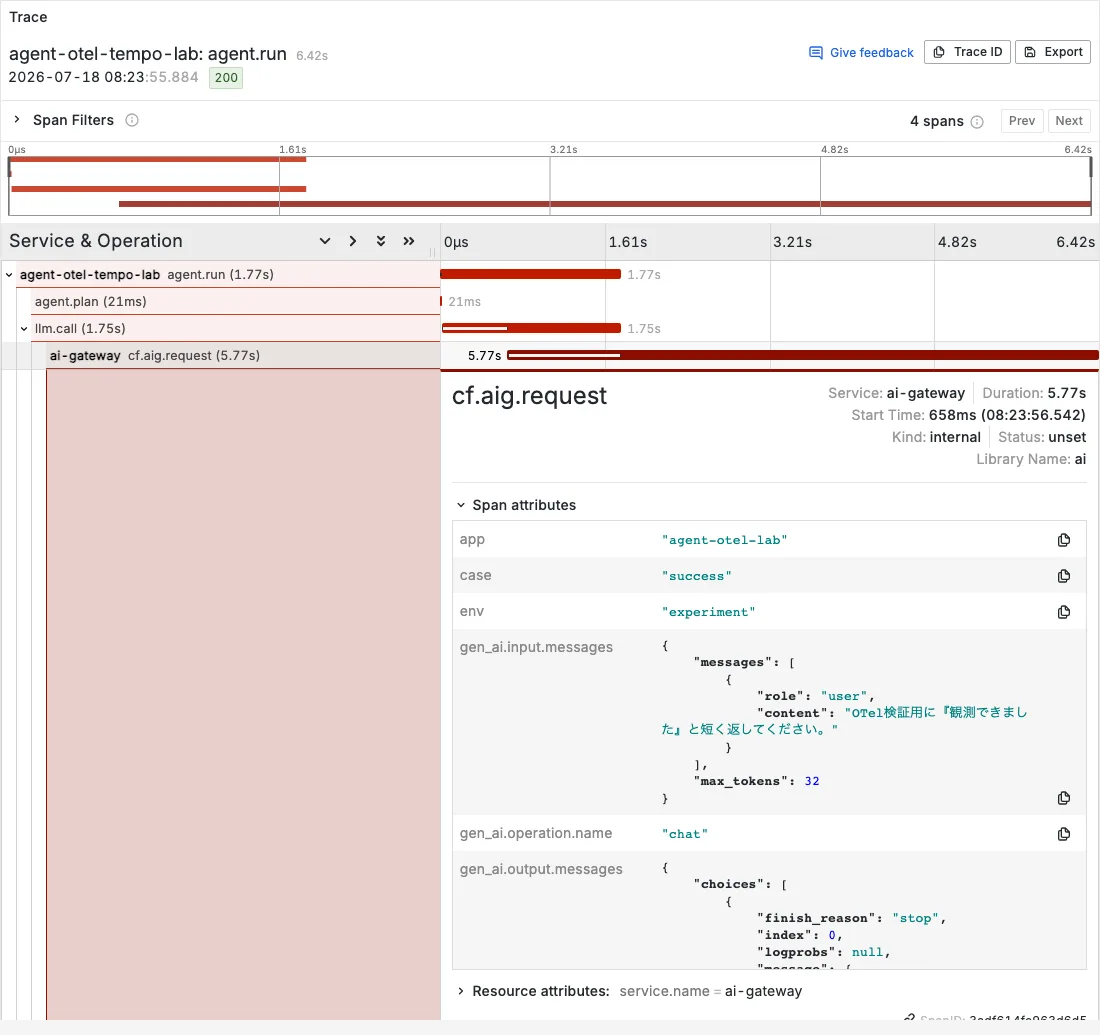
属性名の差分と、input/output本文の保存範囲には注意が要ります。
一つ目は、検証時点のCloudflare公式ページに載るgen_ai.model.provider、gen_ai.prompt_json、gen_ai.completion_jsonと、実際に受け取ったgen_ai.provider.name、gen_ai.input.messages、gen_ai.output.messagesが一致しなかったことです。後者はOpenTelemetryの現在のGenAI属性レジストリに沿った名前です。ダッシュボードやTraceQLを属性名へ固定する前に、実データを1回確認した方がよさそうです。
二つ目は、inputとoutputの本文がspan属性に入ることです。OpenTelemetryの仕様も、message属性には機微情報や個人情報が含まれ得ると注意しています。Tempoへ送れることと、本文を保存してよいことは別問題です。送信先の保持期間、閲覧権限、マスキングを先に決める必要があります。
そして、このspanには回答の品質を説明する情報がありませんでした。gen_ai.evaluation.*に相当するscore、label、理由は0件です。
これはTempoの欠陥ではありません。AI Gatewayが観測できるのは、Gatewayを通過したモデル呼び出しです。「回答が質問に合っているか」「フォールバック後の回答を採用してよいか」という判定は、アプリや評価器が持つ情報です。その結果を独自spanや属性として追加しなければ、Tempoにも現れません。
TempoとLangfuseで観測する対象を分ける
「品質評価が見えないなら、TempoではなくLangfuseを選べばよい」と結論づけるのは早いです。今回の結果では、どちらか一方を常に選ぶより、調べたい問題で役割を分ける方が自然でした。
| 調べたいこと | 向いている観測先 |
|---|---|
| API、DB、queue、LLMをまたぐ遅延 | OpenTelemetry + Tempo |
| timeout、retry、fallbackの処理順 | アプリspan + Tempo |
| AI Gateway通過時のmodel、tokens、cost | AI Gatewayログ / OTel span |
| prompt、completion、評価score、評価理由 | LangfuseなどのLLM評価基盤、またはアプリ側の評価span |
| 失敗リクエストの全数確認 | アプリログとAI Gatewayログを併用 |
既存のサービスがすでにOpenTelemetryを使っているなら、AI Gateway spanをTempoへ加える価値は大きいです。LLMだけ別画面に閉じず、APIやDBと同じ時間軸で調べられます。
一方で、回答品質を継続的に評価し、promptの版やdataset、score、feedbackを扱うなら、汎用traceだけで運用画面を組むのは手間がかかります。その領域ではLangfuseのようなLLM向けのデータモデルが助けになります。
私なら、Tempoをシステム遅延と障害調査の軸にし、Langfuseを回答品質と評価ループの軸にします。両方へ全部の本文を複製するのではなく、共通のtrace IDを持たせ、必要なときに行き来できる形から始めます。
正常応答、失敗件数、回答品質で観測先を使い分ける
AI Gatewayログだけでは説明できなかったAgent全体の待ち時間は、Tempo上で処理段階へ分解できました。正常応答では、アプリのllm.callとGatewayのcf.aig.requestが1本のtraceにつながり、Agentの計画、LLM待ち、フォールバック判断を同じ時間軸へ並べられます。
ただし、今回の検証ではタイムアウトとモデル指定エラーのAI Gateway spanが欠けました。OTel spanのdurationも、アプリの待ち時間やAI Gatewayログのdurationとは一致しません。正常系の1本がきれいにつながったからといって、それだけを監視の原本にはできません。
Tempoで見えたのは、処理がどこを通り、どこで待ち、どこで失敗したかです。見えなかったのは、その回答をなぜ良い、あるいは悪いと判断したかでした。
遅延のtraceと品質の評価は、似ているようで別の観測です。AI GatewayのOTelは前者を既存基盤へ接続する役割として使い、失敗ログと評価結果は別の観測点で補う。1本につながったtraceは、観測が完成した証拠ではありません。