Todoアプリの改修を運営者向け画面からAIに頼めるか 優先度追加と修復ループ編
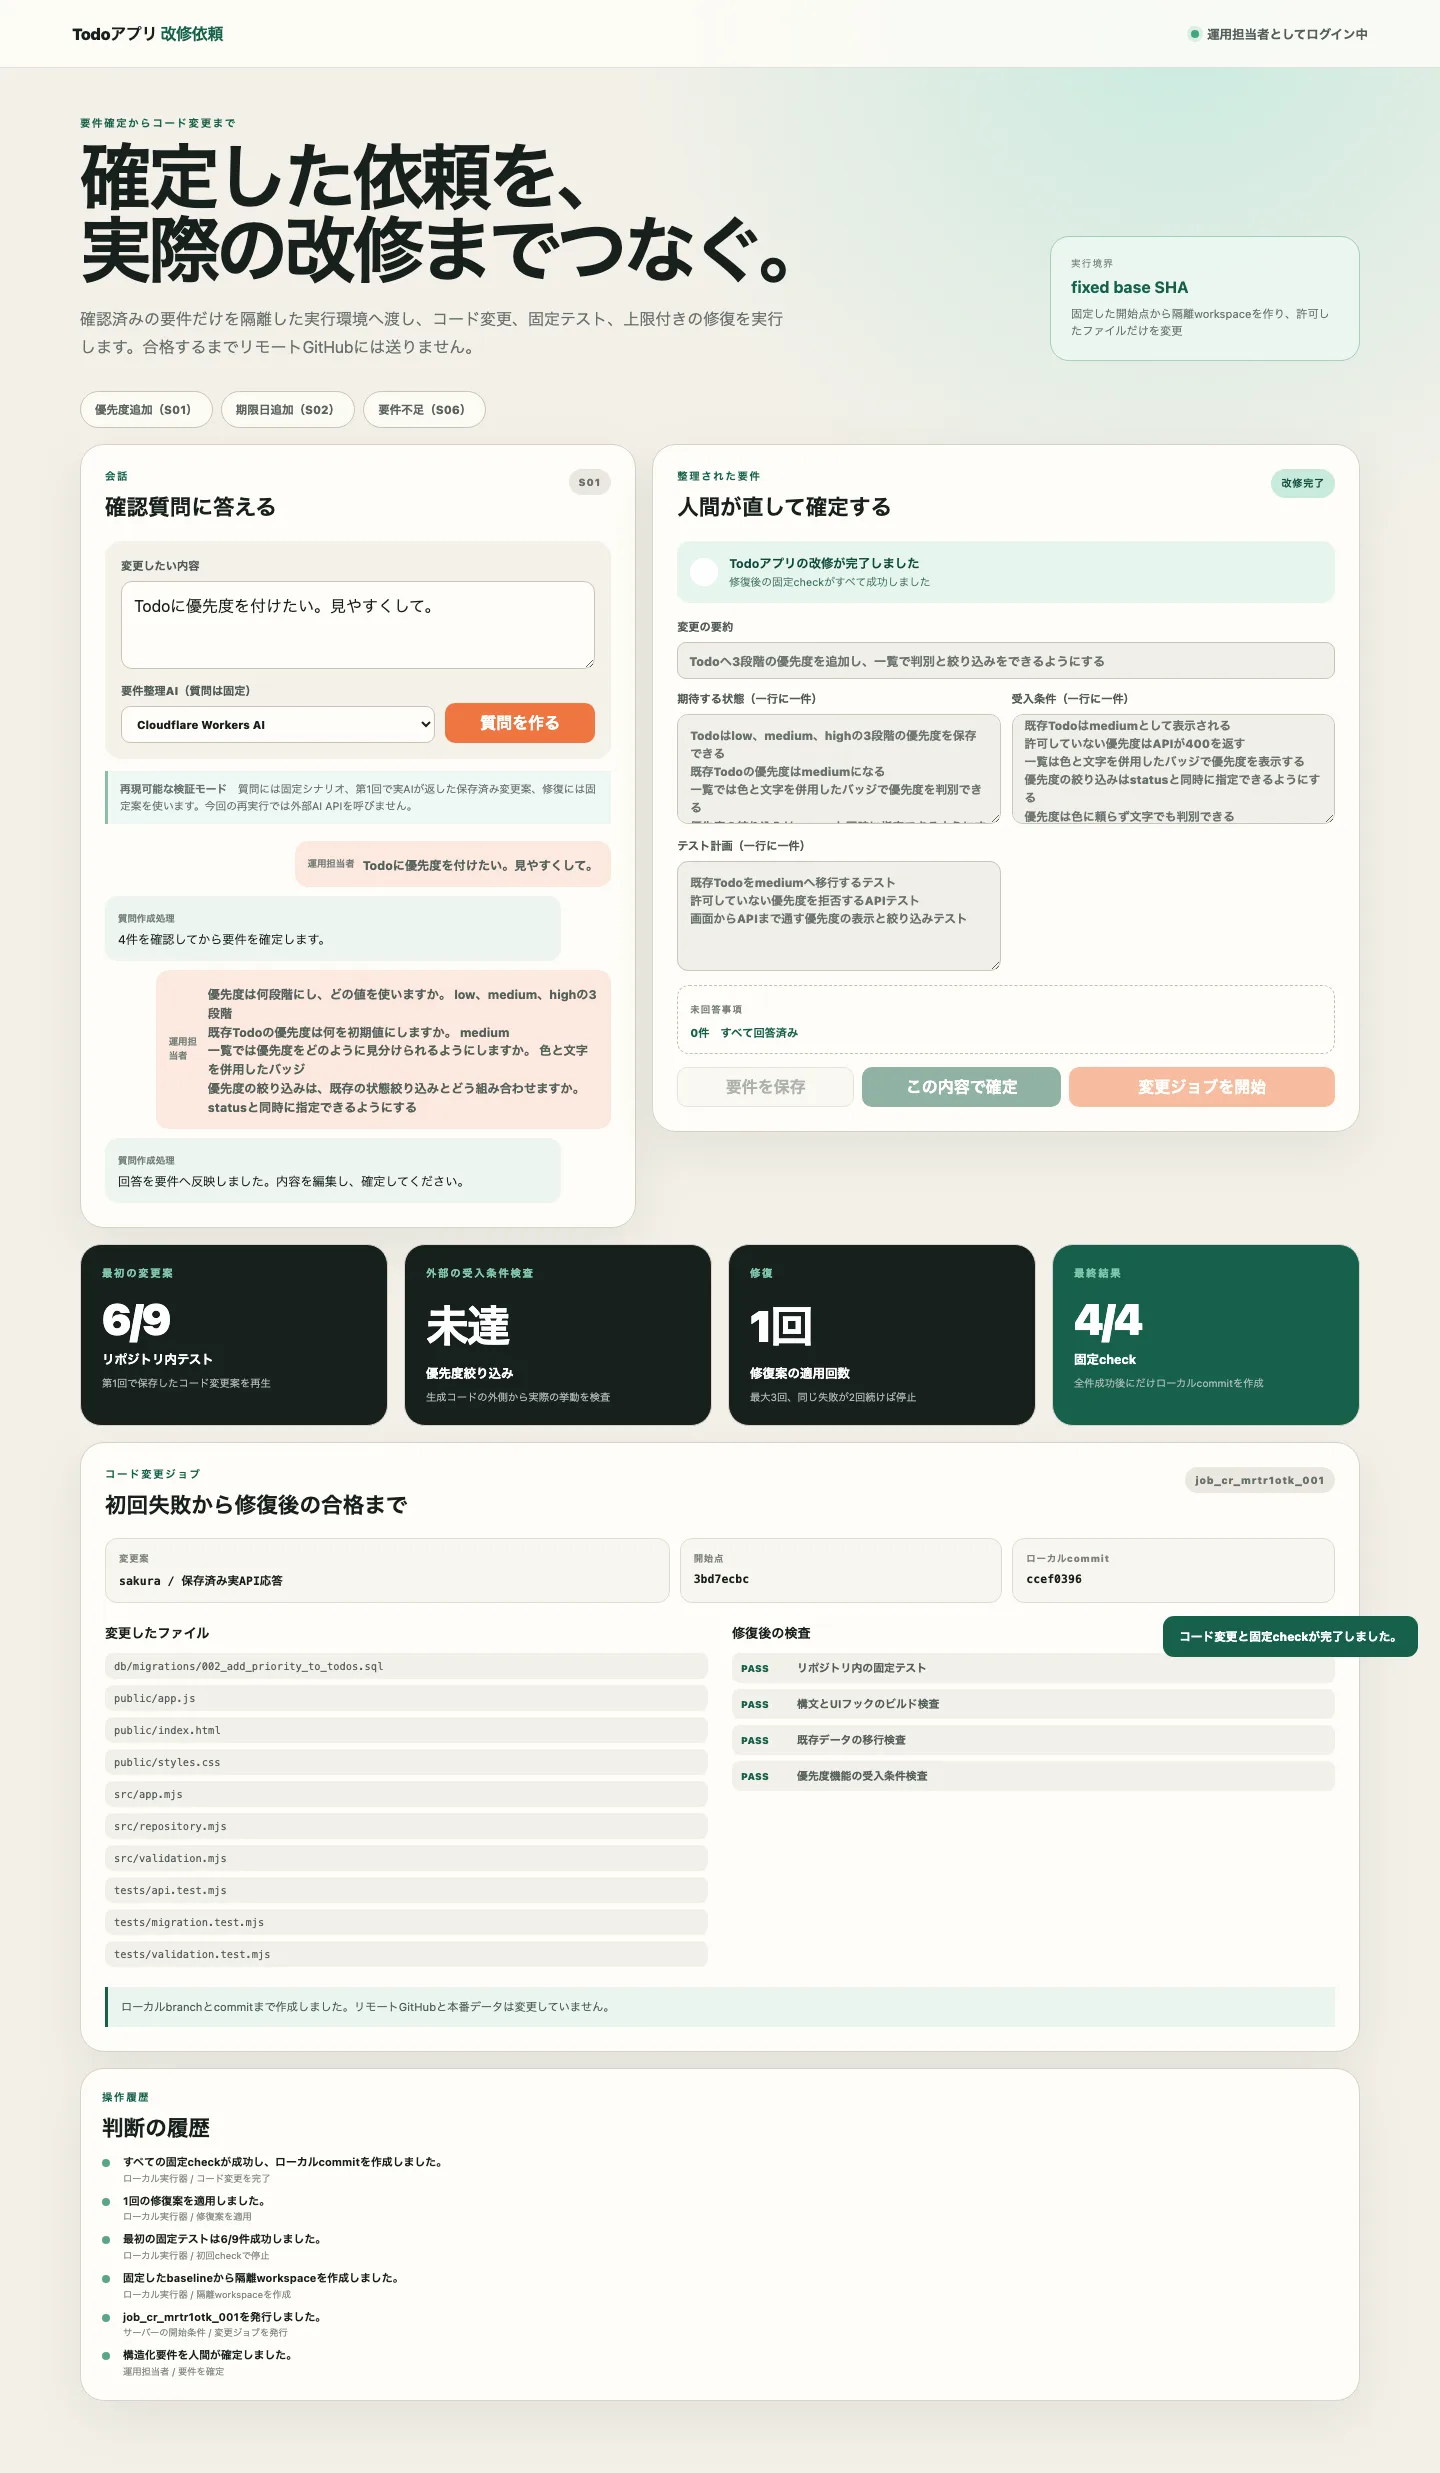
第2回で確定した優先度追加の依頼を、固定した開始点から作る隔離環境へ渡しました。第1回の保存済みAI変更案はリポジトリ内テスト9件中3件と優先度絞り込みの受入条件検査に失敗しましたが、固定修復案を1回適用した後は4種類の検査に合格し、リモートGitHubを変えずにローカルcommitまで作成できました。
第2回で確定した優先度追加の依頼を、固定した開始点から作る隔離環境へ渡しました。第1回の保存済みAI変更案はリポジトリ内テスト9件中3件と優先度絞り込みの受入条件検査に失敗しましたが、固定修復案を1回適用した後は4種類の検査に合格し、リモートGitHubを変えずにローカルcommitまで作成できました。
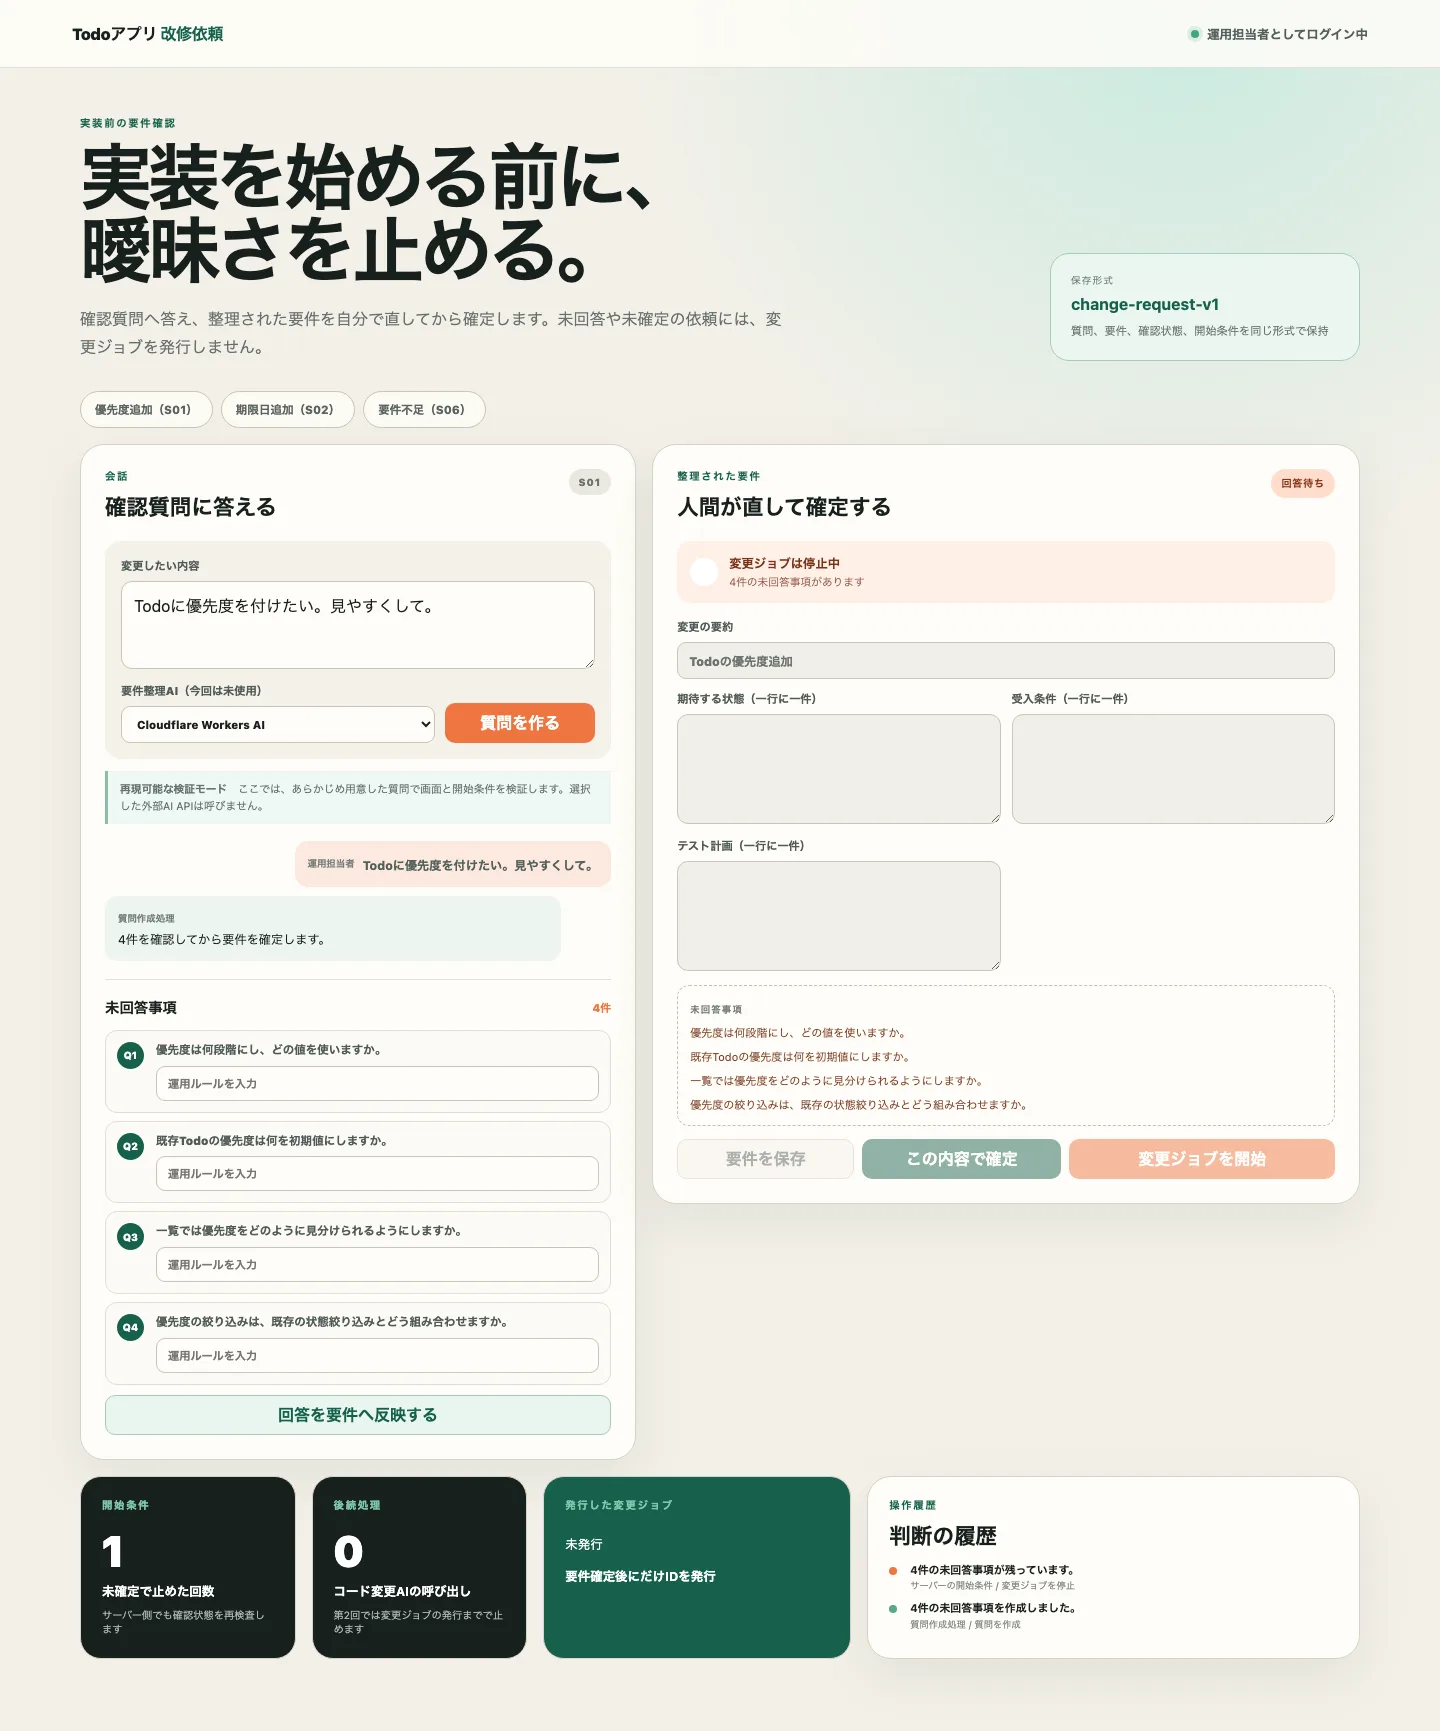
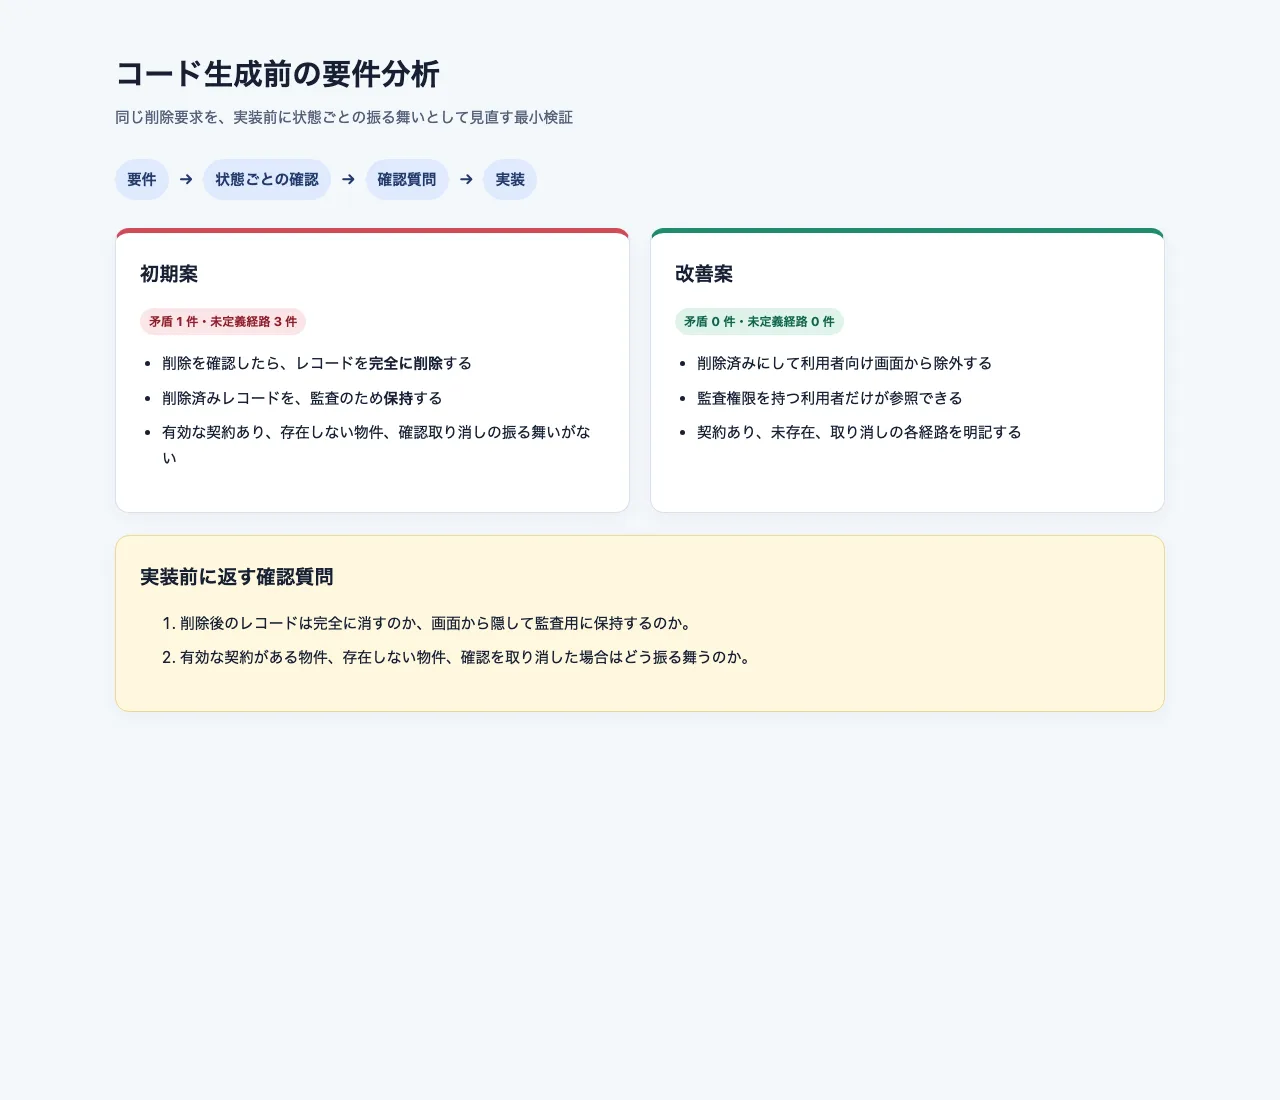
「Todoに優先度を付けたい。見やすくして」のような曖昧な依頼を、確認なしで実装へ渡さないための画面を作りました。質問への回答、要件の手動編集、人間による確定を記録し、未回答や未確定ならサーバー側で変更ジョブを止められるかを検証します。
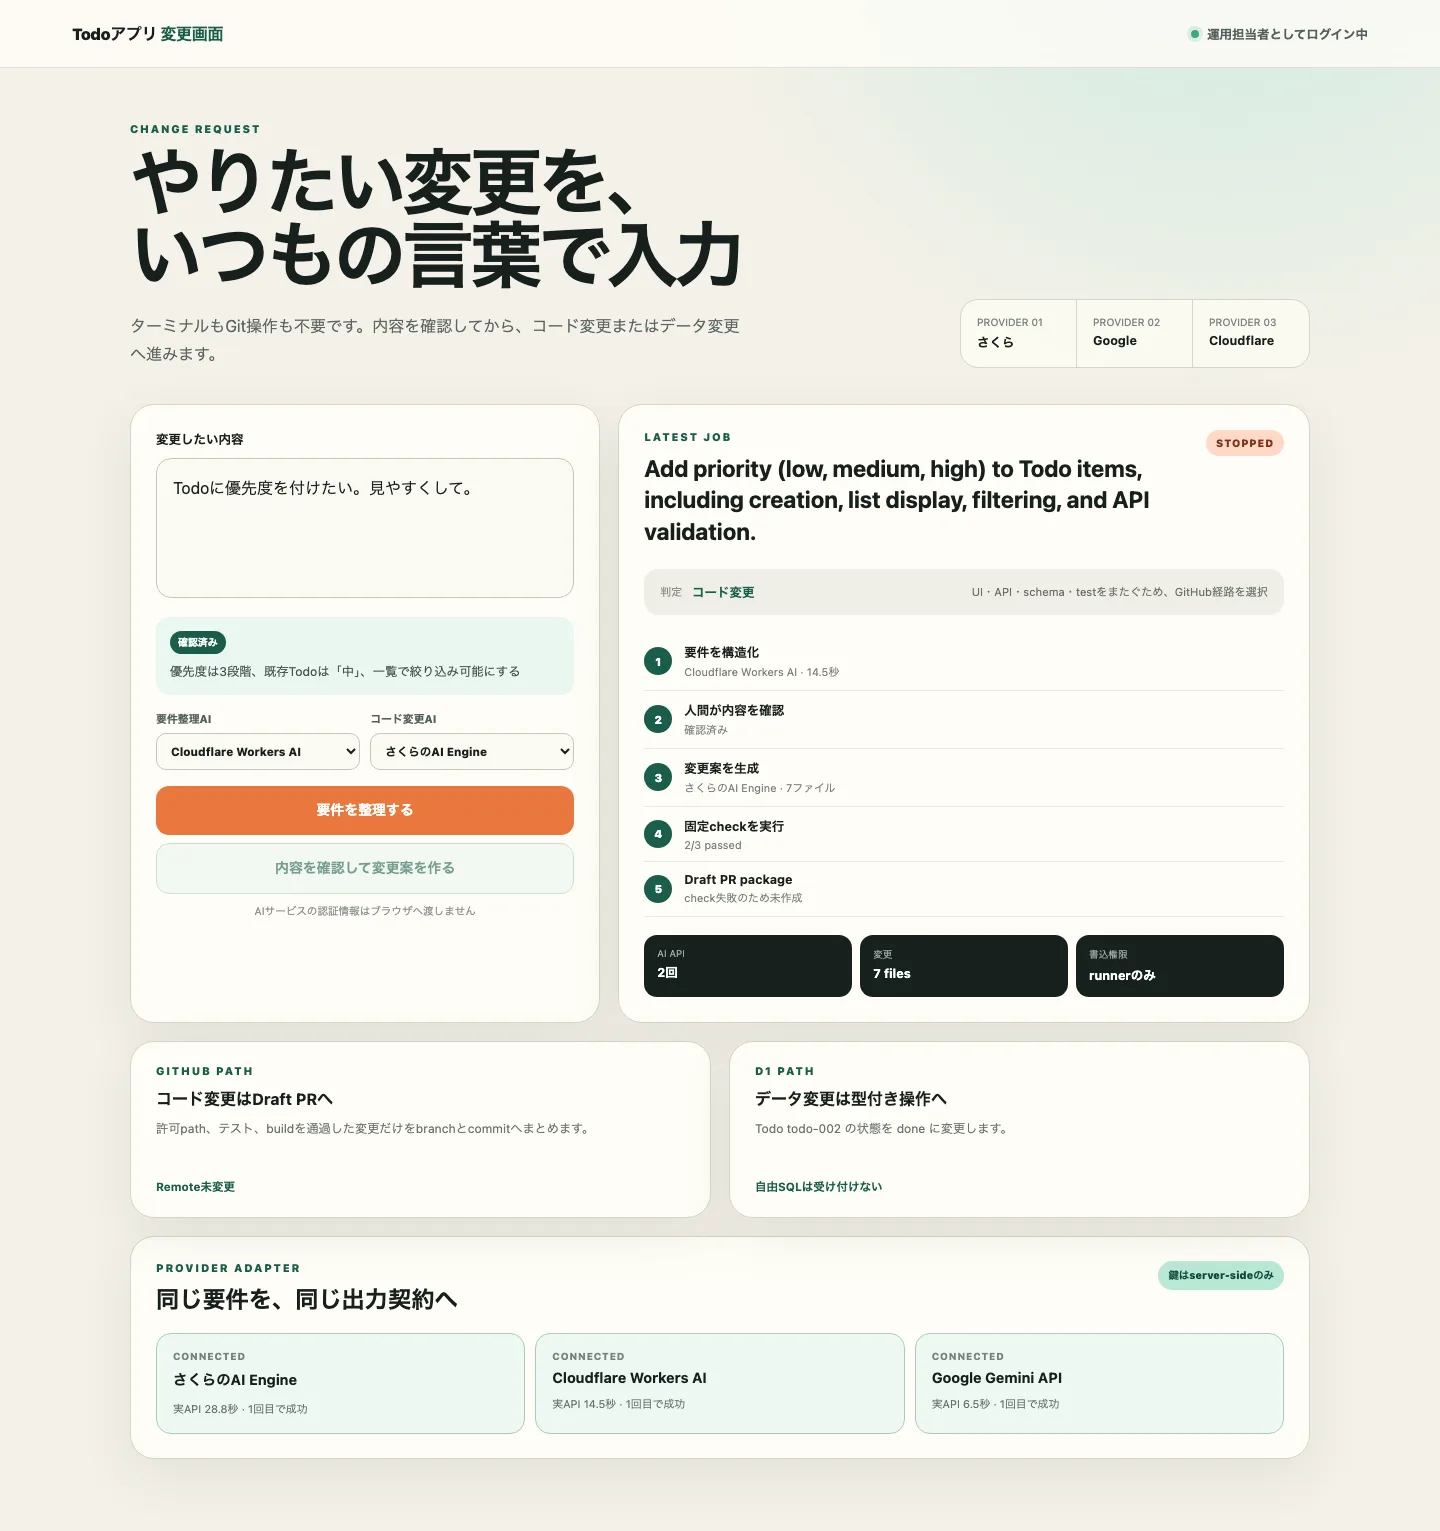
専用Web画面からTodoアプリの変更を依頼し、さくらのAI Engine、Cloudflare Workers AI、Google AI Studioの応答を共通形式へそろえました。7ファイルのコード変更案は固定テスト9件中3件に失敗して停止し、GitHubと本番D1を変更せずに保てるかを検証します。
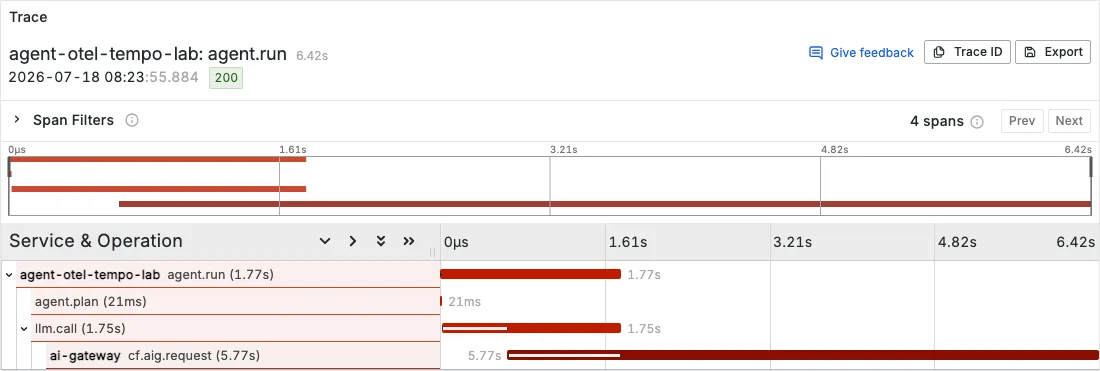
Cloudflare AI GatewayとNode.js AgentのOpenTelemetry spanを同じtrace IDでGrafana Tempoへ送り、正常応答、クライアントタイムアウト、モデル指定エラー、フォールバックを比較した。Tempoに届いた正常応答spanと届かなかったエラーspan、アプリ・Gatewayログ・OTel spanのduration差、回答品質に別の観測点が必要な理由を整理する。
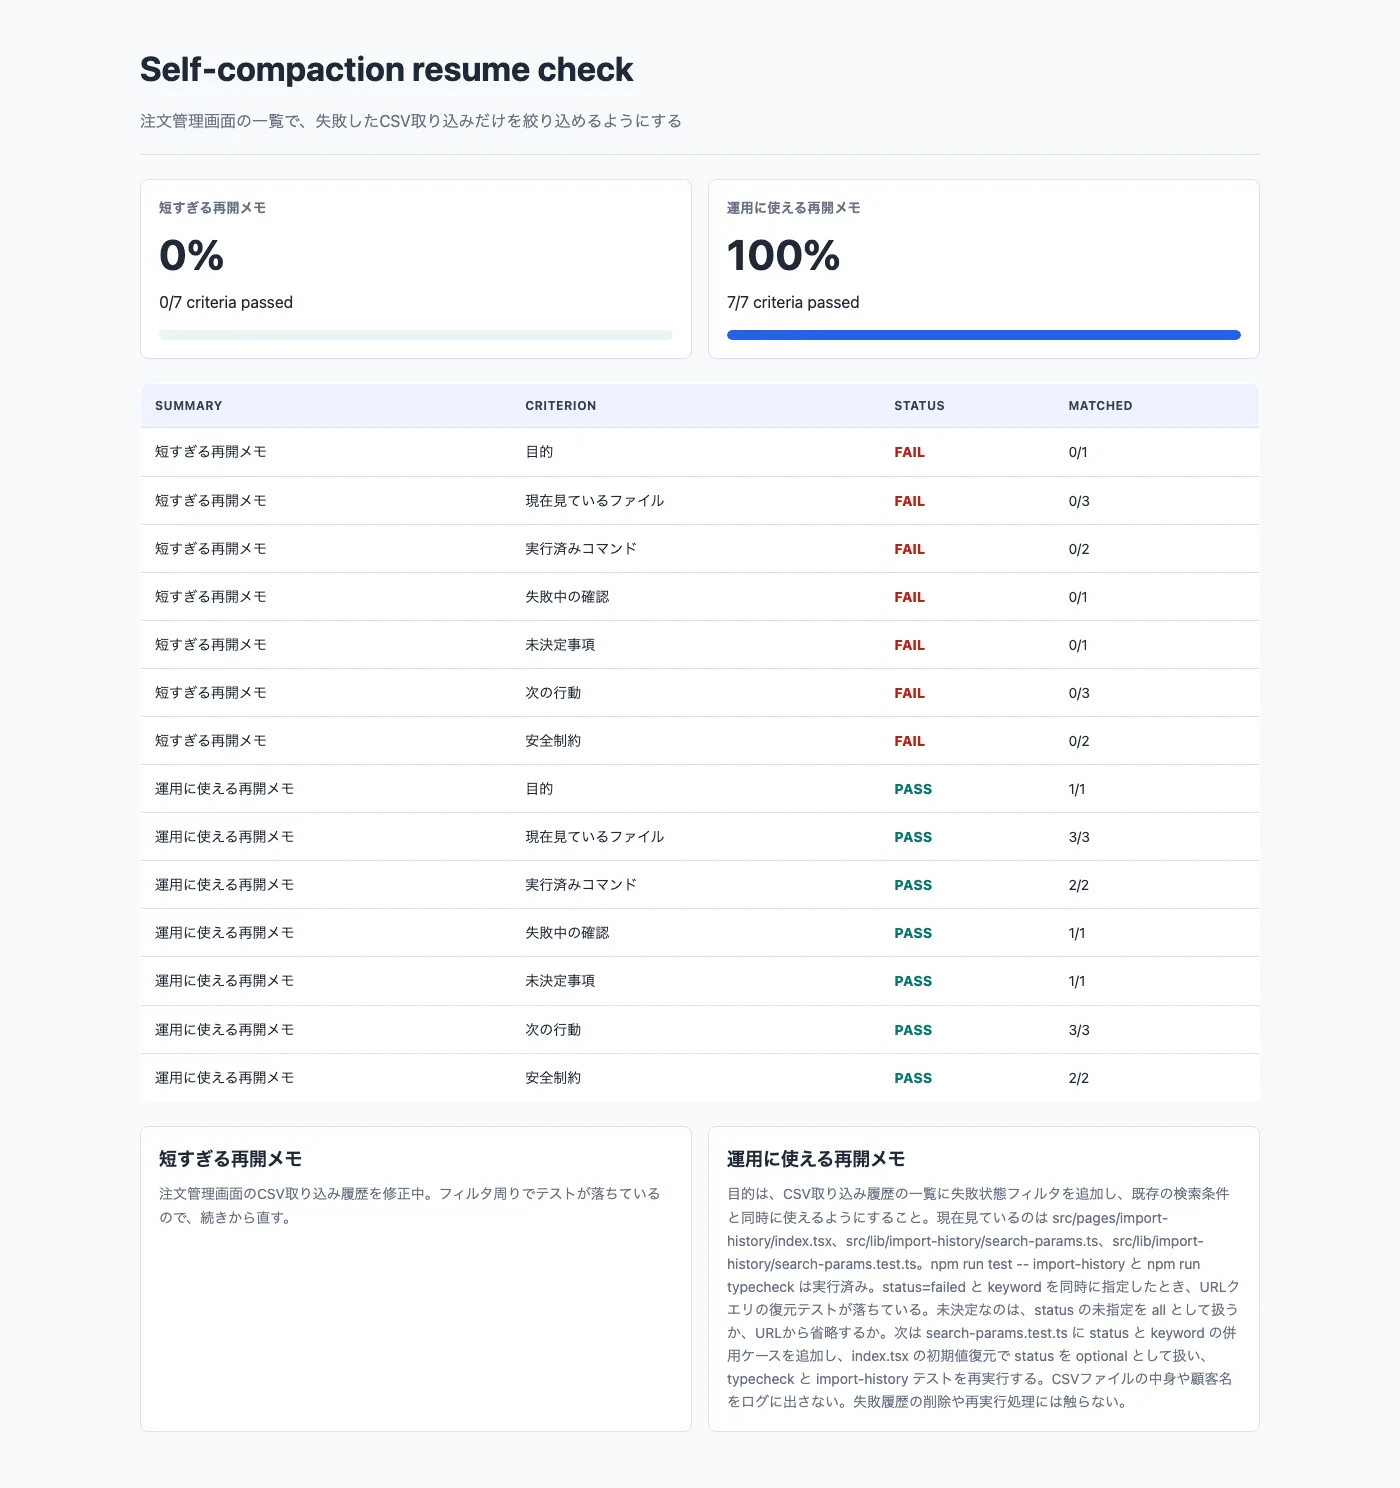
CognitionのSWE-1.7記事をきっかけに、長時間化するAI駆動開発で作業を再開できるメモには何が必要かを、外部APIに依存しない検証スクリプトで確認しました。
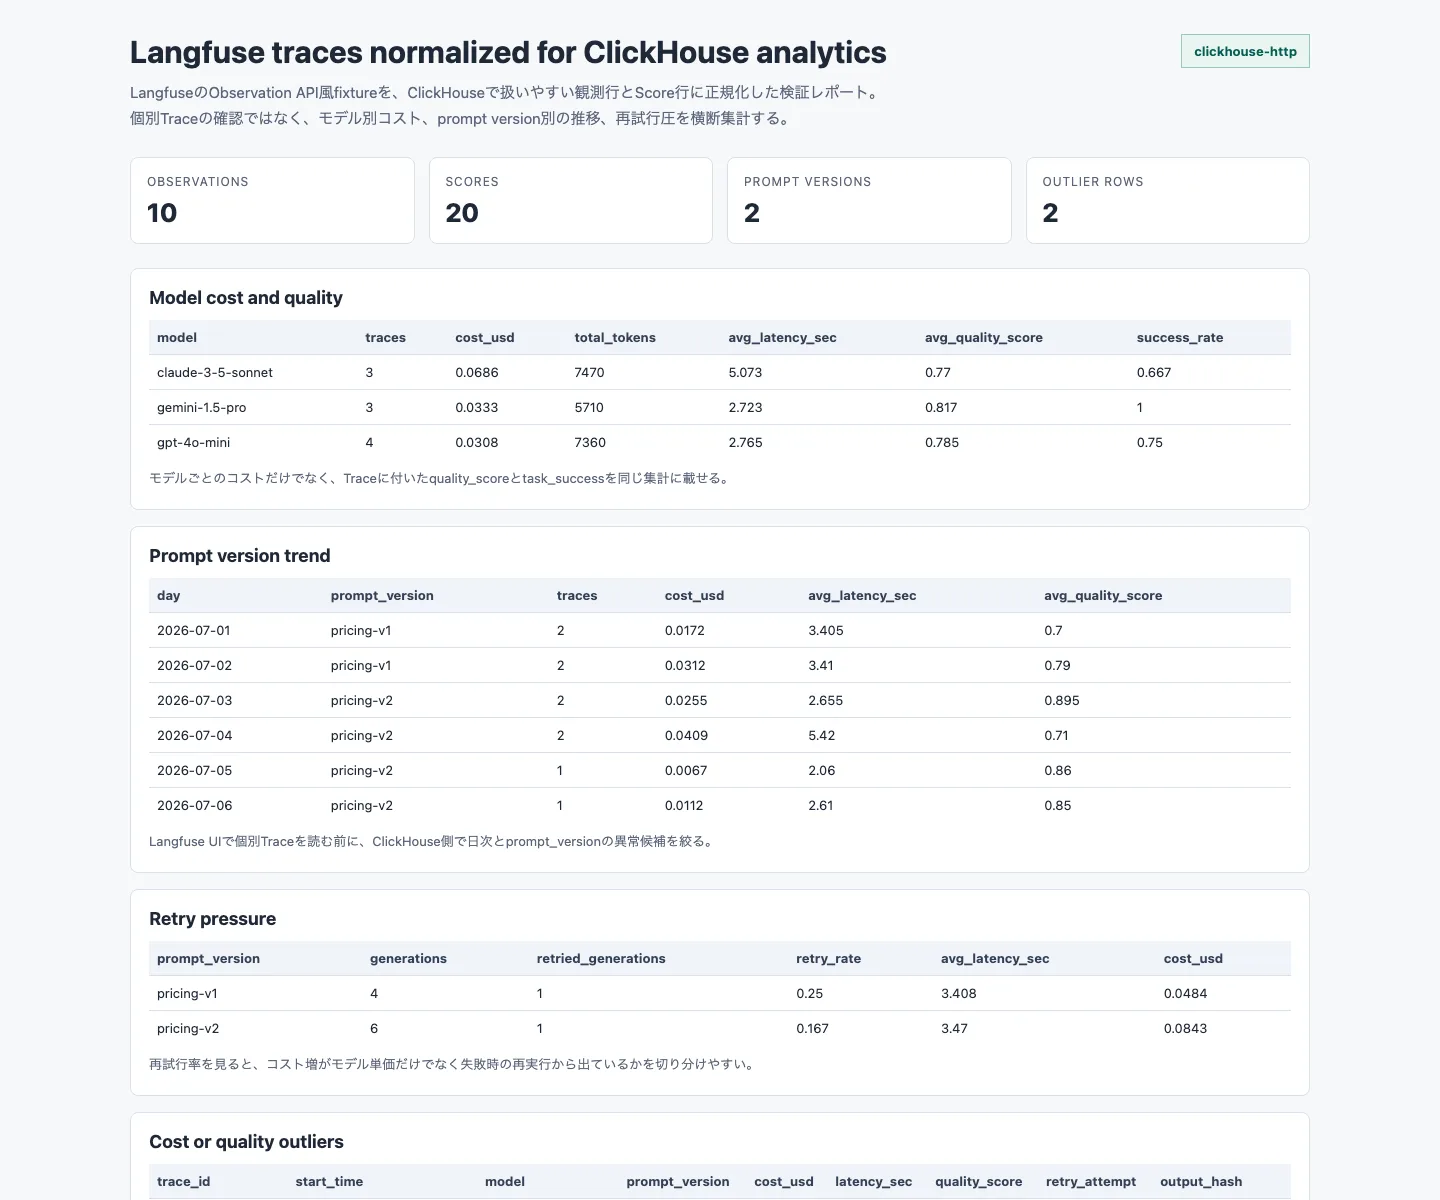
LangfuseのObservationとScoreをClickHouseへ正規化し、モデル別コスト、prompt version別の品質推移、再試行によるコスト増をSQLで確認する検証ログ。
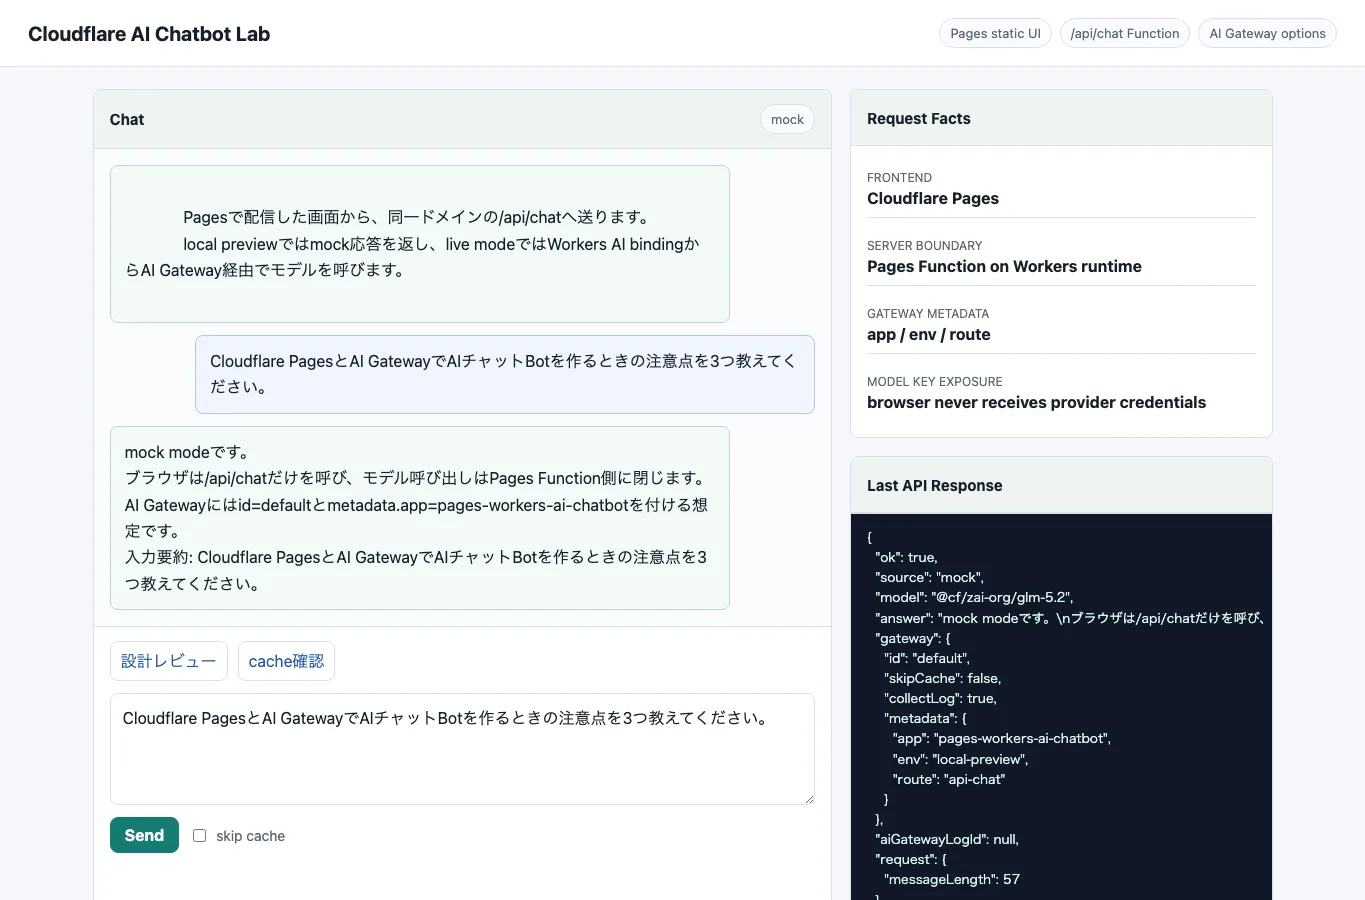
Cloudflare Pagesの静的UI、Pages Function、Workers AI binding、AI Gatewayを組み合わせ、ブラウザにAPIキーを出さないAIチャットBotの最小構成を検証する。
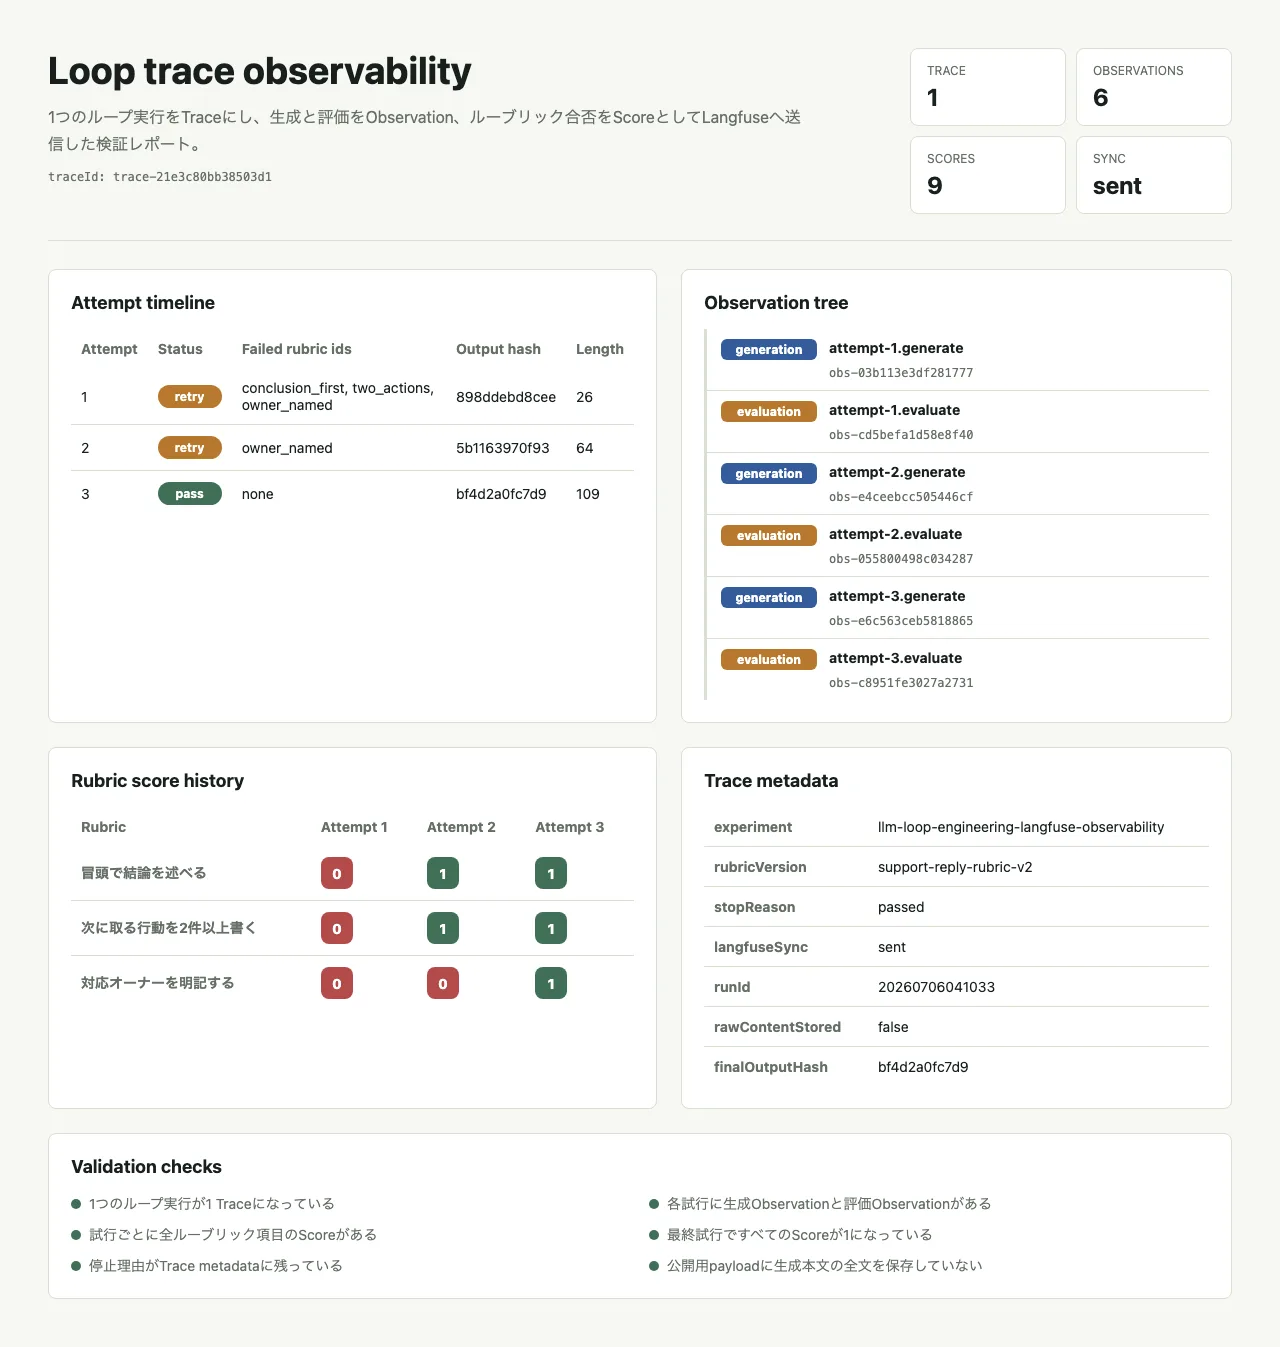
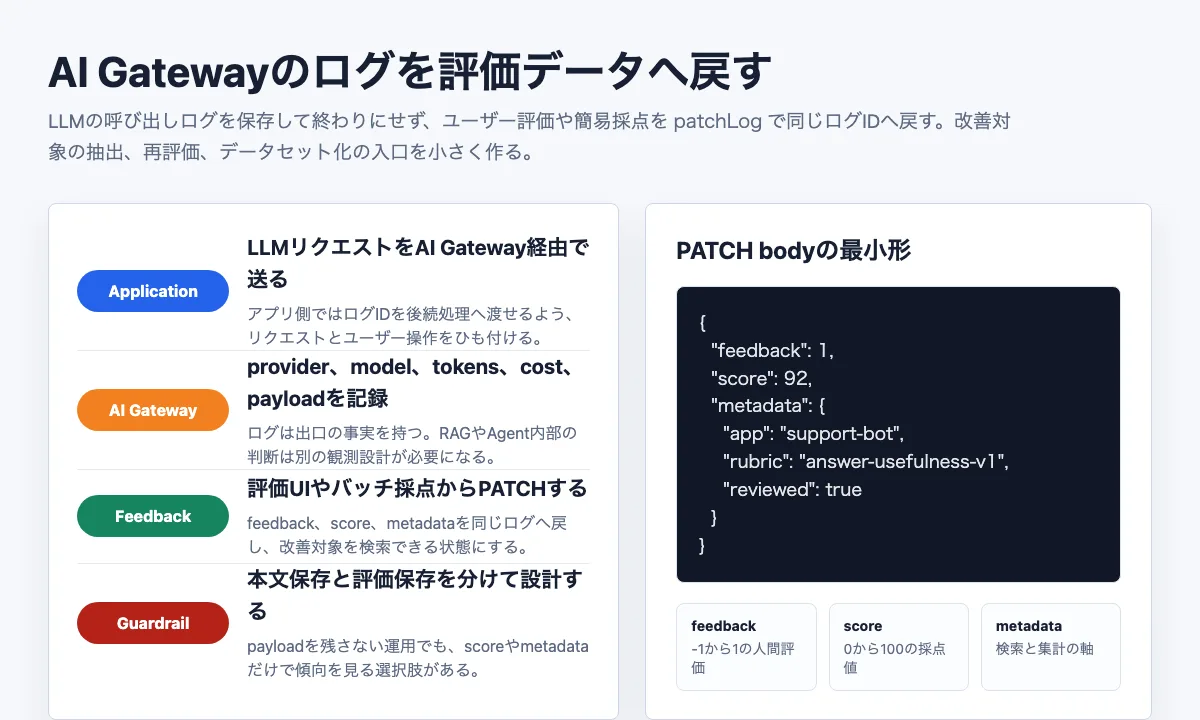
AI Gatewayのログにfeedback、score、metadataを後付けし、LLMのリクエストログを改善対象の評価データへ変えるための小さな検証メモ。
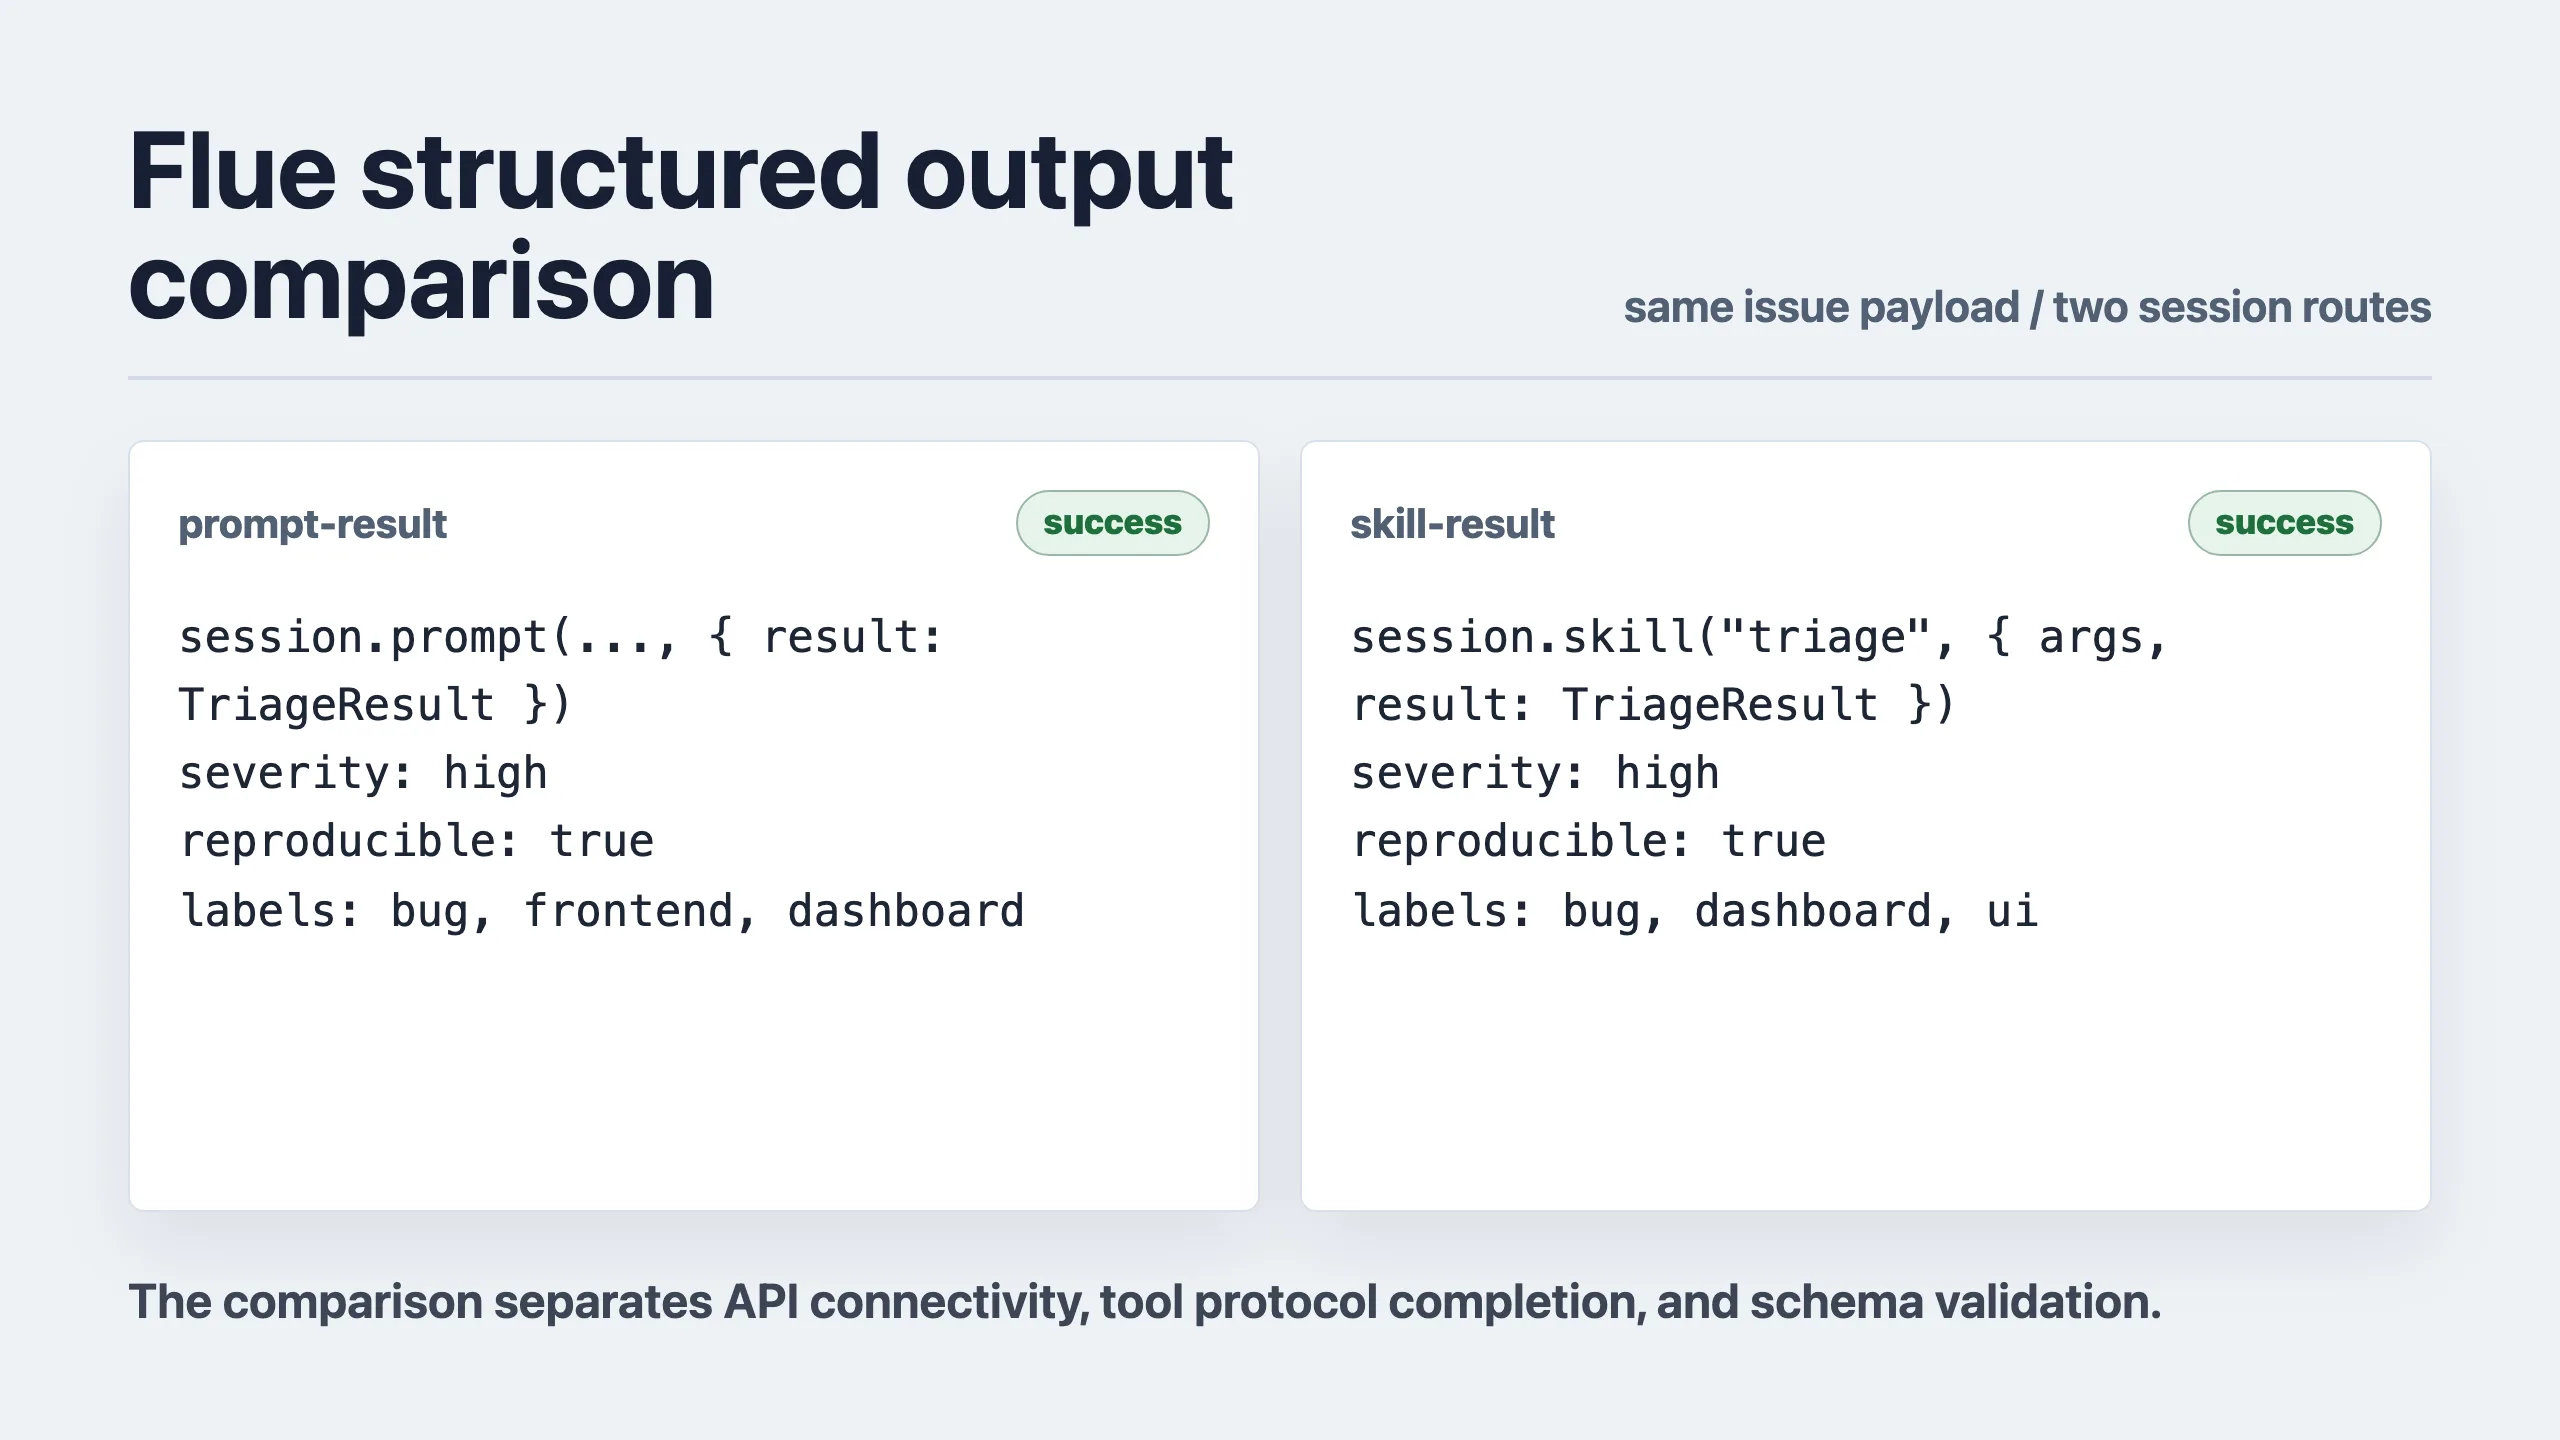
Flue 1.0 BetaのIssueトリアージAgentで、通常の指示とSkillの明示実行を同じ入力で比べ、finish到達、schema検証、分類品質を分けて確認した検証メモ。