ループを入れる前に止める。どのタスクをループ化しないか
APIコスト、待ち時間、評価可能性、決定論的な代替手段を事前ゲートにして、ループ化を見送るタスクを固定シナリオで判定します。
この記事は「 ループ設計 」シリーズの第 6 回です — 5 記事
ループ設計シリーズでは、生成、評価、フィードバック、再生成を分け、失敗を次の試行へ返す構造を作ってきました。観測までつなぐと、どの評価項目が何回目で改善したかも追えるようになります。
ここまで動くと、素朴な誘惑が生まれます。品質を改善できるなら、対象を増やせばよいのではないか。
ところが、ループは品質だけを増やす仕組みではありません。評価用のAPI呼び出し、再生成の待ち時間、試行回数に比例する料金、停止条件を保守する仕事も同時に増やします。しかも、合否を安定して決められないタスクでは、何回回しても「改善したから止める」という判断ができません。
ループを作る技術と同じくらい、作らない判断が要ります。では、その判断を実装前のどこに置けばよいのでしょうか。
LLM Lab ループは回った。でも何が効いたのか分からない 生成と評価を試行ごとのObservationとScoreへ分け、改善経路を観測した第5回です。 https://llm-lab.dev/posts/llm-loop-engineering-langfuse-observability/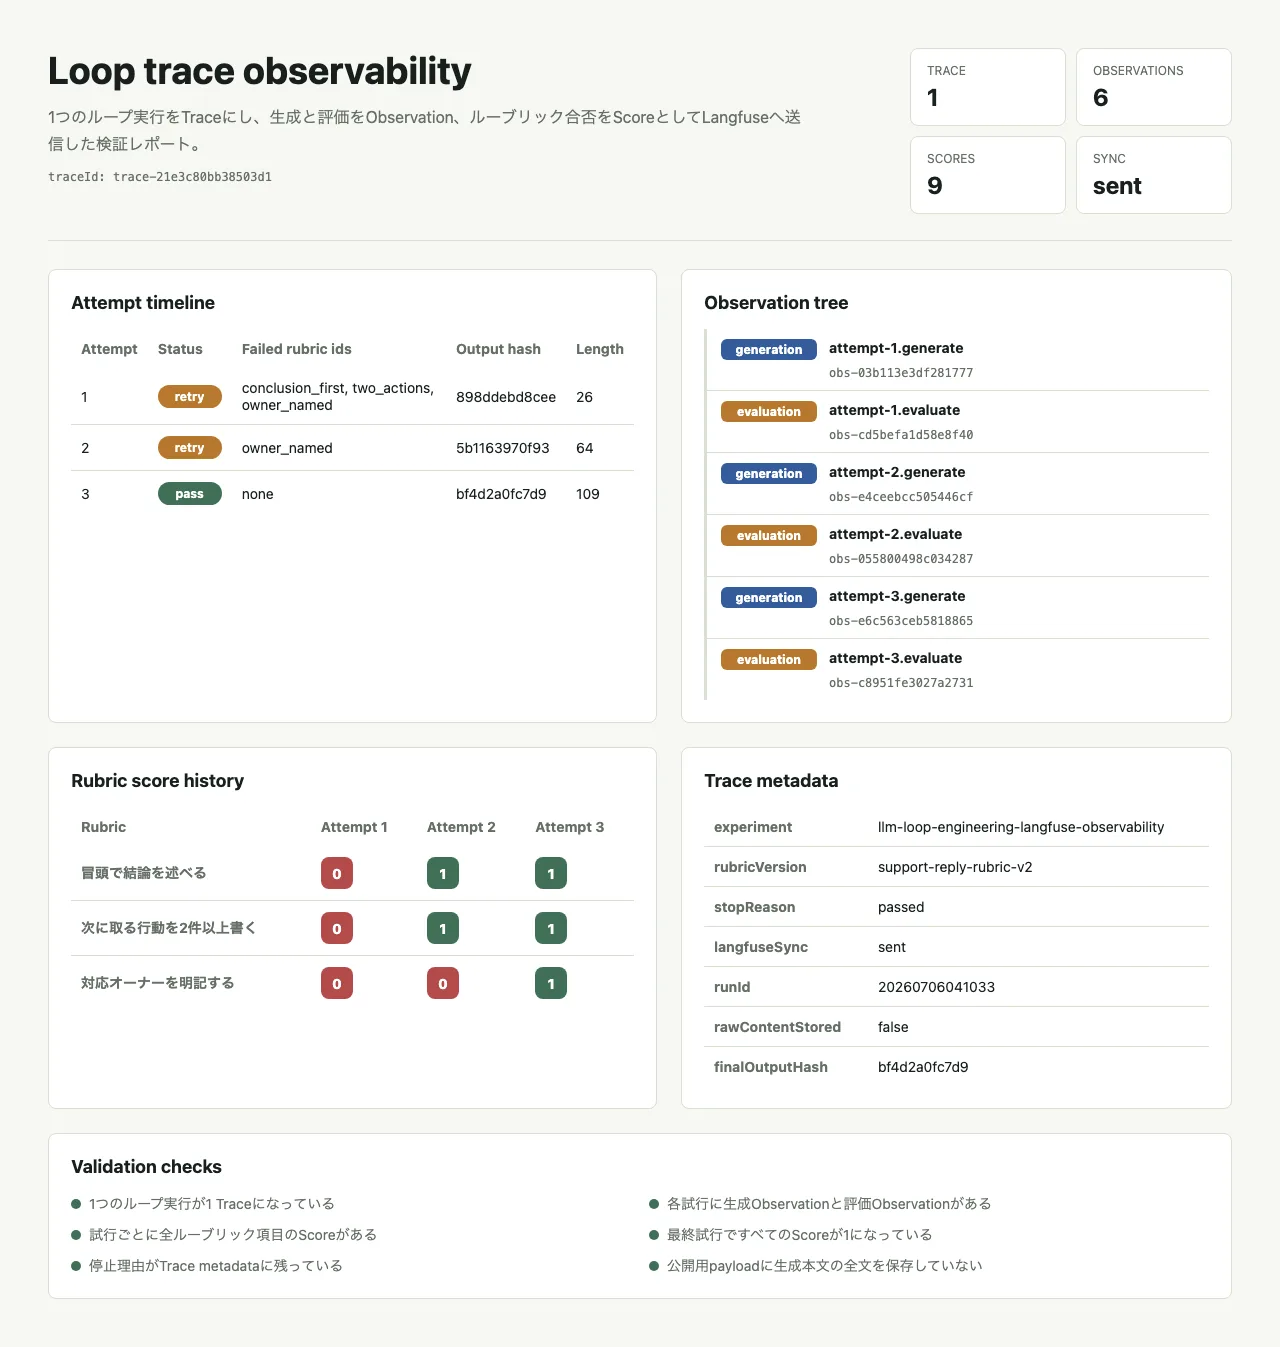
最大試行回数を決める前に、入口を閉じる
最大3回で停止する仕組みがあれば、無限ループは防げます。ただし、3回なら妥当だとは限りません。止まることと、採算が合うことは別です。毎回の生成後に評価を呼ぶ構成では、最大試行時に生成3回と評価3回を支払います。リクエスト数が増えれば、小さな単価も月額では無視できません。
そこで、実装前の入口を次の順序で判定しました。
- 同じ結果を決定論的なコードで再現できないか
- 出力の合否を十分な一貫性で評価できるか
- 最大試行まで回っても利用者が待てるか
- 最大試行が続いても予算内に収まるか
一つ目は、LLMが必要かどうかの判定です。計算、型、必須項目、正規表現で同じ合否を返せるなら、再生成ループより通常のプログラムを優先できます。
二つ目は、停止条件を作れるかの判定です。生成できることと評価できることは別です。「ブランドらしい」「エモい」「経営判断として妥当」といった条件は、評価者が変わるたびに合否が揺れる可能性があります。揺れた評価を次の試行へ返すと、ループは改善ではなく方向転換を繰り返します。
三つ目と四つ目で、システムとして払える時間と料金を見ます。ここでは平均試行回数を使いません。導入前には実績分布がないため、最大試行まで使った場合の上限から始めます。
5つの固定シナリオを同じゲートへ通す
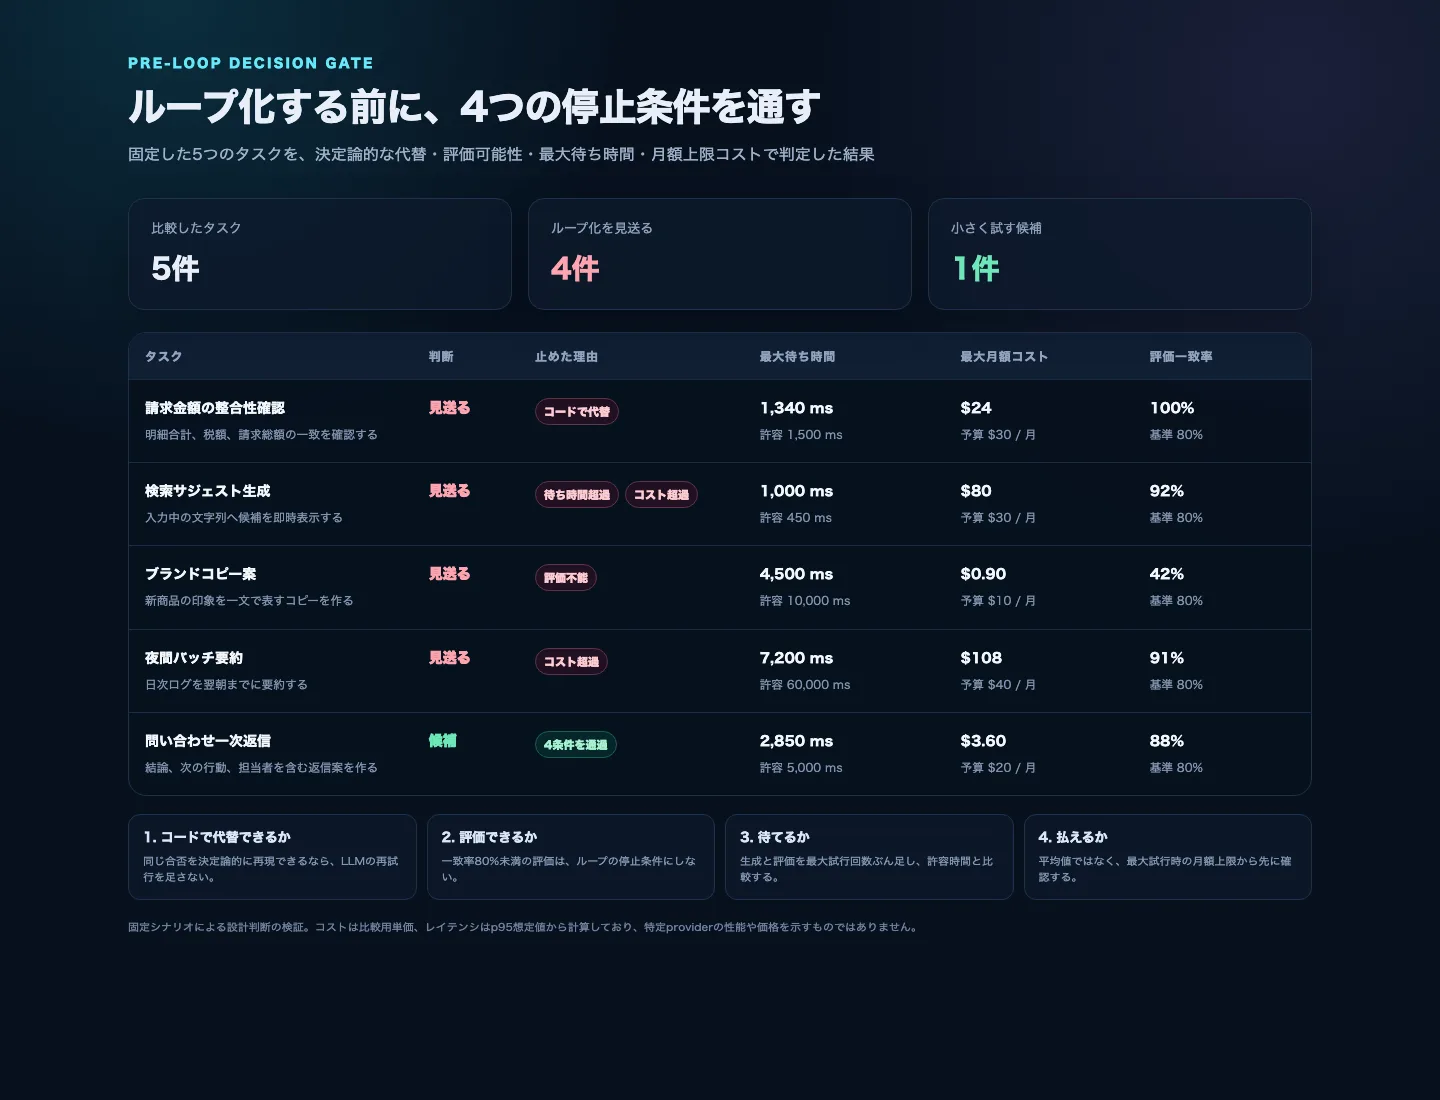
4つの条件を並べただけでは、どの入口が実際に閉じるのか分かりません。そこで、請求金額の整合性確認、検索サジェスト、ブランドコピー、夜間バッチ要約、問い合わせ一次返信の5タスクを固定入力にしました。外部LLM APIは呼んでいません。タスクごとに月間件数、最大試行回数、生成と評価の1試行あたりコスト、生成と評価のp95想定値、許容時間、評価者間の一致率を与えています。
npm run verify は、この記事用に用意した自作の検証コマンドです。固定した5タスクを判断ゲートへ入力し、期待した見送り理由になることをアサーションで確認したうえで、JSONとHTMLの比較レポートを作ります。公式CLIや特定providerの評価コマンドではありません。
待ち時間とコストは、次の最小計算で上限を置きました。
const maximumLatencyEstimate = maxAttempts *
  (generationP95Ms + evaluationP95Ms);

const maximumMonthlyCost = monthlyVolume * maxAttempts *
  (generationCostPerAttempt + evaluationCostPerAttempt);
生成p95と評価p95の加算値は、実測のエンドツーエンドp95ではありません。構成要素の遅い側を重ねた保守的な事前見積もりです。また、コストはすべての処理が最大試行回数へ達する前提なので、実運用の平均より大きく出る可能性があります。
評価者間の一致率は80%以上を通過条件にしました。この80%も一般標準ではなく、判定ロジックを確認するための固定値です。実務では、人間が合否を付けたサンプルや複数評価者の結果から、タスクごとに許容水準を決める必要があります。
通過したのは、問い合わせ一次返信だけでした。
4対1という件数から採用率を論じることはできません。ただし、同じ「ループ化しない」という判断でも、決定論的な代替、待ち時間、評価の揺れ、月額上限と、止まった理由が異なることは比較できます。
正解をコードで出せるなら、評価AIを足さない
請求金額の整合性確認は、最大待ち時間1,340ミリ秒が許容1,500ミリ秒以内、月額上限24ドルが予算30ドル以内、評価一致率も100%という条件にしました。時間、料金、評価可能性だけを見ればゲートを通ります。
それでも見送りです。明細合計、税額、請求総額の一致は、計算式と型チェックで同じ結果を再現できるからです。
LLMに計算結果を再生成させて評価するより、計算結果をコードで確定し、不一致なら入力エラーとして返すほうが、失敗の意味を説明できます。ループを入れない理由は、LLMの精度が低いからではありません。確率的な再試行を持ち込む必要がないからです。
利用者が待てないなら、品質改善の機会も届かない
検索サジェストは、生成320ミリ秒、評価180ミリ秒、最大2回という固定条件です。最大待ち時間の見積もりは1,000ミリ秒になり、許容450ミリ秒を超えました。月間5万件では、月額上限も80ドルとなり、予算30ドルを超えます。
評価一致率は92%なので、合否を決めること自体はできます。それでも、入力のたびに1秒待つ設計は採れません。評価できることは、同期処理の待ち時間を消してくれないからです。
この種のタスクでは、一発生成の候補を安全なルールで絞る、キャッシュを使う、評価をオフラインへ移すといった分離が考えられます。利用者のリクエスト内で完全なループを閉じる必要はありません。
評価が揺れるなら、停止条件はまだない
ブランドコピー案は、時間と料金には余裕がある一方、評価者間の一致率を42%と置きました。今回の基準80%を下回るため、評価不能として見送っています。
コピー案を複数出すこと自体には価値があります。しかし、評価者ごとに「良い」の意味が変わる状態で、評価モデルの合格を自動停止条件にすると、最後に残った案が最も良いとは説明できません。回数を増やしても、この問題は解けない。
代わりに、禁止表現や文字数のような決定論的条件だけをコードで確認し、主観評価は人間が複数案から選ぶ形に分けられます。主観的なタスクはAIを使えないのではなく、自律ループの合否判定をAIだけに閉じない、という判断です。
非同期でも、件数が多ければ料金で止まる
夜間バッチ要約は、最大待ち時間7,200ミリ秒に対して許容60,000ミリ秒、評価一致率91%としました。翌朝までに終わればよいので、同期処理のレイテンシ問題はありません。
ところが、月間3,000件を最大3回まで回すと、比較用単価でも月額上限は108ドルになります。予算40ドルの2.7倍です。遅くても困らない処理が、安い処理とは限りません。
ここでは対象を全件から失敗候補だけへ絞る、初回出力をコードで事前判定する、月額予算に達したら人間確認へ送る、といった入口制御が必要です。最大試行回数を2回へ減らすだけでなく、そもそも何件をループへ入れるかを決めなければ、件数の掛け算は残ります。
4条件を通っても、本番採用には届かない
問い合わせ一次返信は、結論が先にあるか、次の行動が2つ以上あるか、誰が対応するのかが書かれているかを評価する想定です。最大待ち時間2,850ミリ秒は許容5,000ミリ秒以内、月額上限3.60ドルは予算20ドル以内、評価一致率は88%としました。決定論的な代替もありません。
この固定条件では、5件のうち唯一のループ候補です。
ただし、ゲート通過は本番採用を意味しません。次に必要なのは、少数の実データで初回合格率、実際の試行回数、品質差、評価の誤判定を観測することです。もし初回と3回目で業務上の差がなければ、条件上は回せてもループを入れる便益がありません。
判断ゲートは、実験してよい候補を絞ります。実験結果の代わりにはなりません。
実務では4つの値を観測値へ置き換える
では、固定シナリオで残った候補を、いつ本番の判断へ進められるのでしょうか。比較用の固定値を実測値へ置き換えたあとです。実際のタスクでは、少なくとも次の値を観測します。
- 生成と評価、それぞれのp50とp95レイテンシ
- 1試行あたりの入力・出力トークン数と実コスト
- 何回目で合格したかの分布と、最大試行到達率
- 人間の正解ラベルに対する評価器の一致率と誤判定
これらが揃えば、全件が最大試行まで進む上限見積もりから、実際の試行分布を使った期待値へ移れます。第5回で分けたattempt、Score、停止理由は、ここでコストと待ち時間の判断材料になります。
逆に、値が取れない段階で精密な費用対効果を装う必要はありません。決定論的な代替がある、評価が安定しない、許容時間を超える、上限予算を超える。そのどれかが明らかなら、先に入口を閉じられます。
まとめ
今回の固定シナリオでは、請求金額の整合性確認はコードへ戻し、検索サジェストは同期ループを外し、ブランドコピーは人間の選択を残し、夜間バッチ要約は対象件数を絞る判断になりました。問い合わせ一次返信だけが、次の実験へ進みます。
生成品質を改善できる可能性だけでは、タスクをループ化する理由になりません。決定論的なコードで代替できず、合否を安定して評価でき、最大試行時の待ち時間と料金を受け入れられる。この4条件を通って、ようやく小さく試す候補になります。
最大試行回数を決める前に、そのタスクを入口で止める条件を決める。ループ設計の最初の仕事は、回数ではなく対象を選ぶことでした。