Todoアプリの改修を運営者向け画面からAIに頼めるか プロバイダ切り替えと安全停止編
専用Web画面からTodoアプリの変更を依頼し、さくらのAI Engine、Cloudflare Workers AI、Google AI Studioの応答を共通形式へそろえました。7ファイルのコード変更案は固定テスト9件中3件に失敗して停止し、GitHubと本番D1を変更せずに保てるかを検証します。
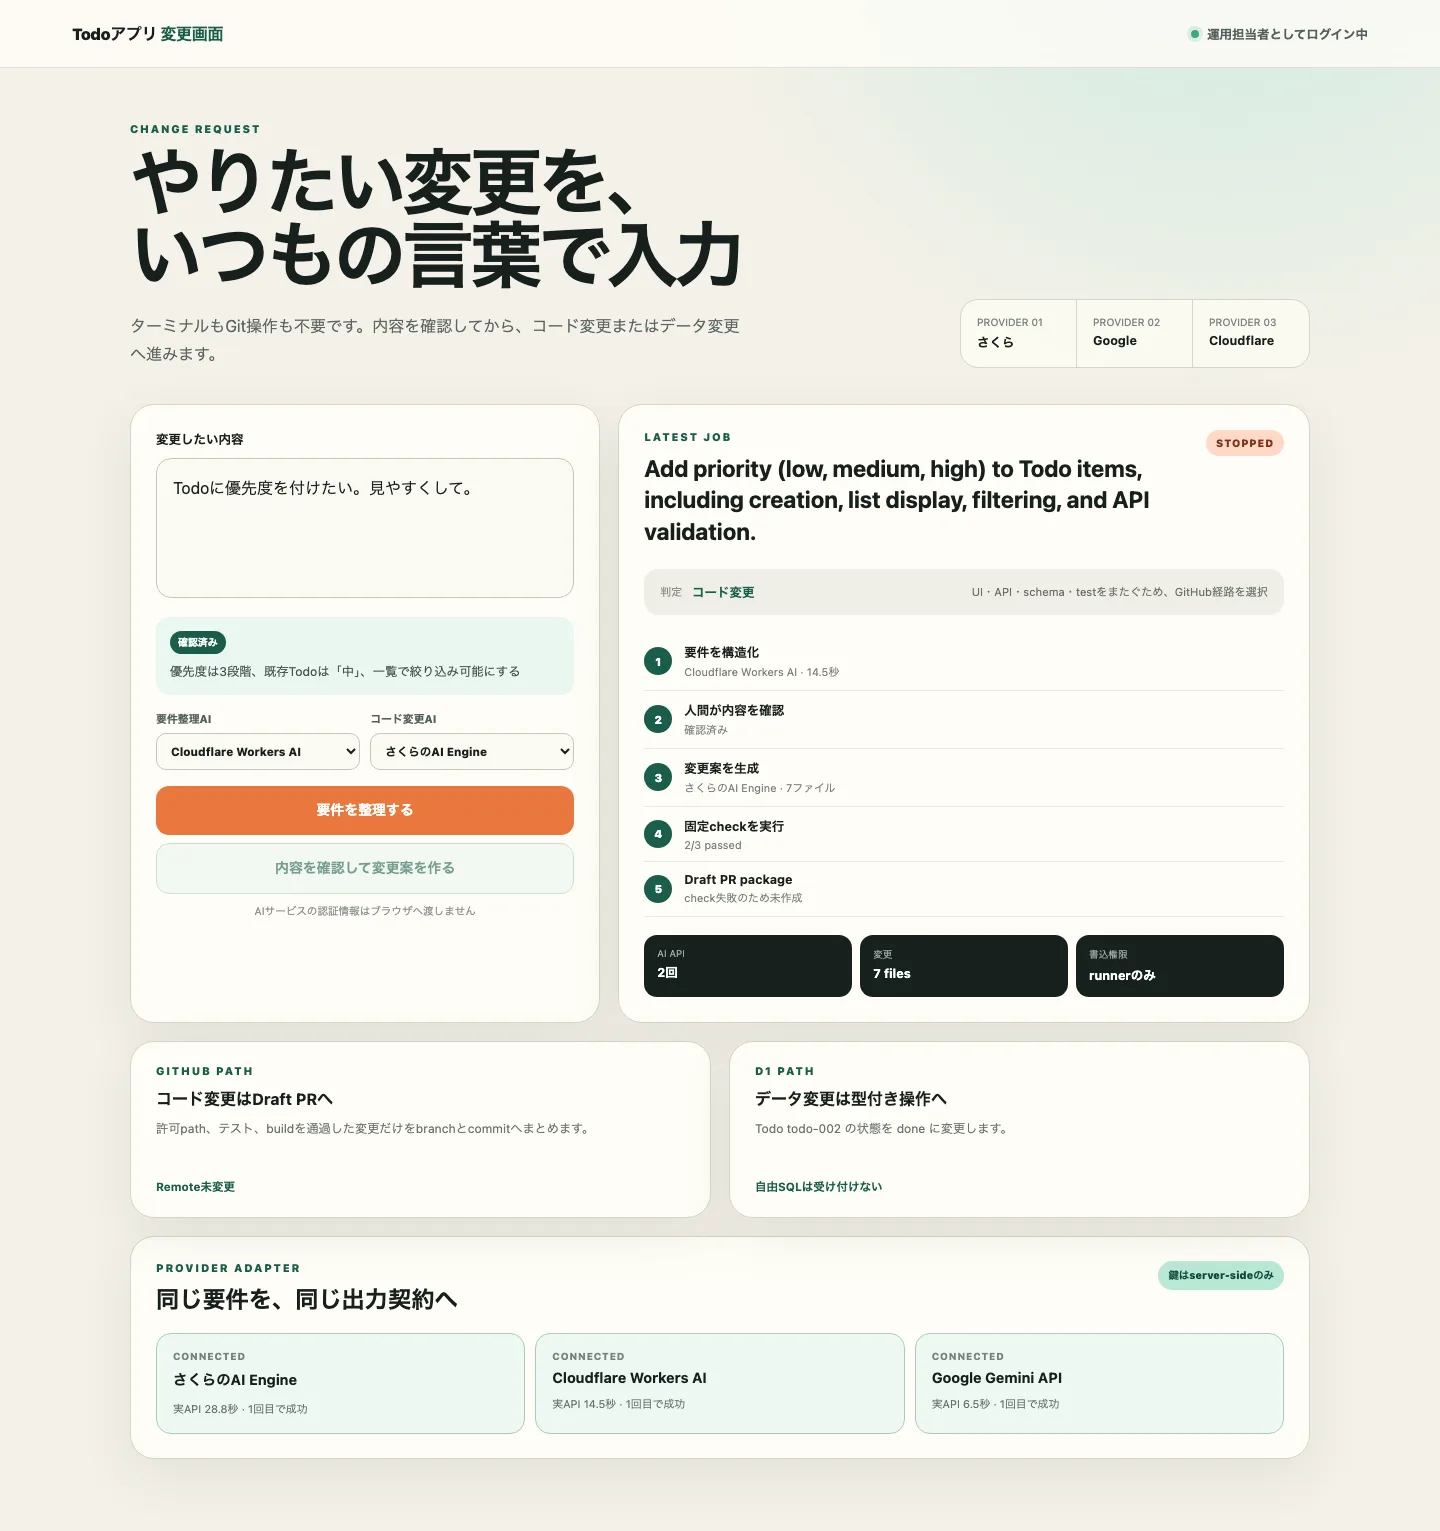
チャットでの改修依頼からDraft PRまでを段階的につなぐ
今回の検証は、Gitやターミナル、AI開発ツールを直接操作しないTodo CMSの運用担当者でも、専用Web画面からTodoアプリの改修を依頼できるかを確かめるシリーズの第1回です。
シリーズの最終ゴールは、利用者がチャットで改修を依頼し、AIの確認質問に答え、構造化された要件を自分で編集して確定すると、隔離環境でコード変更とテストが実行され、合格した変更だけがGitHubのDraft PRになる仕組みを作ることです。 最後に10種類の改修を同じ条件で試し、人間が既存のコーディングエージェントへ手動で依頼する方法と比べて、実用性を判定します。
第1回となる今回は、その入口と安全境界を作ることにしました。 専用Web画面から3社のAIプロバイダを切り替え、自然文の依頼からコード変更案を生成し、隔離したワークスペースで固定テストにかけました。 チャットで確認質問に答えて要件を確定する機能、失敗した変更の自動修復、GitHubへのDraft PR作成は、まだ行っていません。
この実験用画面だけを見ると、かなりうまくいっているように見えます。
「Todoに優先度を付けたい。見やすくして」と入力し、要件整理にはCloudflare Workers AI、コード変更にはさくらのAI Engineを選ぶ。 あとはボタンを押せば、GitHubのコードもD1のデータも面倒を見てくれそうです。
ところが、結果欄に出たのはREADYではなくSTOPPEDでした。
テストが落ちた変更にREADYを出すより、このSTOPPEDの方が信頼できます。
第1回では、AIがコードを書けるかと同じくらい、怪しい変更を外へ出す前に止められるかを確かめることにしました。
Web画面からGitHubとD1の書き込み権限を切り離す
利用者が触るのは、Todoアプリ変更画面だけです。 その裏側で、AIの認証、リポジトリのスナップショット作成、生成案の検査、Git操作、D1操作をサーバー側へ集めました。
非エンジニアの自然文
  ↓
要件整理AI
  ↓
共通の要件JSON
  ↓
人間が内容を確認
  ↓
  ├─ コード変更 -> 隔離Gitワークスペース -> 固定テスト -> Draft PR
  └─ データ変更 -> 型付き操作 -> プレビュー -> D1
画面からサーバーへ送るのは、依頼文と選択したAIプロバイダのIDです。 APIキーはサーバー内に残します。 コード変更用のAIには必要なソースだけを渡し、GitHubのトークンとD1の認証情報はモデルへの入力から外しました。 返ってきた変更案を実ファイルへ書けるのは、許可されたパスと検査手順を持つ実行器だけです。
3社のAPI応答を同じ要件JSONへそろえる
画面には「要件整理AI」と「コード変更AI」の選択欄を分けて置きました。 どちらも、さくら、Google、Cloudflareの3社から選べます。
三つの選択肢は同じように並んでいますが、呼び出し方はそれぞれ違います。
さくらはOpenAI互換のChat Completions、Cloudflare Workers AIはアカウント単位のREST API、Google Gemini APIはgenerateContentです。
この違いを画面側で扱い始めると、AIプロバイダを替えるたびに後続処理まで分岐してしまいます。
そこで、サーバー側のアダプターでリクエストと応答を変換し、後続処理にはrequirement-plan-v1だけを渡す形にしました。
requirement-plan-v1は、変更経路、現状、期待状態、受入条件、テスト計画、制約、未回答事項を持つ共通形式です。
const result = await runRequirementProvider({
  providerId,
  rawRequest,
  confirmedFacts,
  configuration,
});

validateRequirementPlan(result.plan);
同じ依頼を3社の実APIへ1回ずつ送り、返ってきた要件JSONを同じ検証処理へ通しました。
| AIプロバイダ | モデル | 結果 | 経過時間 | 呼び出し回数 |
|---|---|---|---|---|
| さくらのAI Engine | preview/Kimi-K2.6 | 共通形式の検証成功 | 28.8秒 | 1回 |
| Cloudflare Workers AI | @cf/zai-org/glm-5.2 | 共通形式の検証成功 | 14.5秒 | 1回 |
| Google AI Studio | gemini-2.5-flash | 共通形式の検証成功 | 6.5秒 | 1回 |
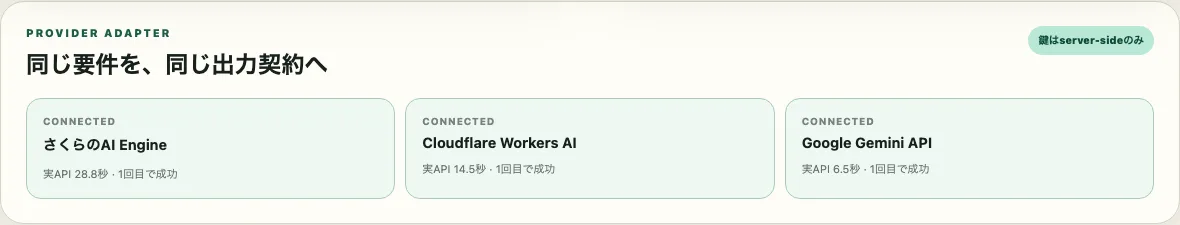
速度や品質を比べるには、各1回という回数も、異なるモデルという条件も足りません。 今回確認できたのは接続までです。 3社の実際の応答を同じ形式へ変換したことで、AIプロバイダの選択と、後段のパス検査や固定テストを分けられました。 AIプロバイダを替えても、停止条件は同じままです。
さくらのAI Engine公式ページでは、OpenAI互換APIとAnthropic互換API、Chat Completions月3,000回の無料枠が案内されています。 Cloudflare Workers AIの料金ページでは、1日10,000 Neuronsの無料枠が案内されています。 無料枠は変わり得るため、公開時には再確認が必要です。
Google AI Studioの利用上限と送信データを先に絞る
Google Gemini APIのアダプターはできていたのに、最初の画面では未設定と表示されました。
APIキーは置いてありました。
設定を読み込む場所と変数名が、実際の配置と合っていなかったのです。
設定の読み込みを直したあと、gemini-2.5-flashへ送る内容は、架空のTodoに優先度を付ける依頼と、その要件を整理するための確認事項に限定しました。
呼び出しは1回、6.5秒で成功し、変更経路をgithub_changeと判断した要件JSONが共通形式の検証を通りました。
今回確認したGoogle AI Studioの利用画面では、Gemini 2.5 Flashの上限は5 RPM、250K TPM、20 RPDでした。 少ない無料枠を実験で使い切らないよう、実行器は呼び出し履歴を保存し、上限に達するリクエストをAPIへ送る前に止めます。
Gemini API Additional Termsには、無償サービスへ送った内容がGoogle製品の改善に利用され、人間のレビュアーが処理する場合があると記載されています。 無料枠で動くかどうかと、非公開リポジトリを送ってよいかどうかは別に考える必要があります。 今回の検証データを架空の依頼に絞ったのは、そのためです。
Cloudflare Workers AIの401を既存の成功経路から調べる
Cloudflareでは、認証だけで二段階つまずきました。
既存の.envにあったトークンでWorkers AI REST APIを呼ぶと、3回ともHTTP 401、エラーコード10000です。
それでも、同じ検証ディレクトリには、Workers AIバインディングからGLM-5.2を呼べた記録が残っていました。
この記録がある以上、APIやモデルより先に、二つの呼び出し経路の差を調べる余地があります。
二つの経路を比べると、401になったトークンは別用途の権限で、成功例はWranglerのOAuthまたはリモートのWorkers AIバインディングを使っていました。
そこでOAuthへ切り替えましたが、今度はwrangler auth token --jsonがトークンを返す前に落ちます。
WranglerのシバンがHomebrewのNode.js 25を拾い、不足しているlibsimdjson.29.dylibを読もうとしていました。
Node.js 22のディレクトリをPATHの先頭へ固定し、OAuthトークンを実行中のメモリへだけ読み込むように変更しました。
再実行では、Cloudflare Workers AIが1回目、14.5秒で成功しました。
env: {
  ...process.env,
  PATH: `${dirname(process.execPath)}:${process.env.PATH}`,
}
401の応答だけでは、Node.js 25の問題は見えませんでした。 以前に通った経路と見比べたから、トークンの権限とNode.jsのバージョン選択を別々に調べられました。 成功した小さな実証を残しておくと、後日のエラー調査にも使えます。
さくらの7ファイル変更案を固定テストにかける
要件JSONがそろったところで終われば、確認できるのは要件整理までです。
Todoアプリのコードまで進めるため、さくらのAI EngineでQwen3-Coder-30B-A3B-Instructを1回呼び、Todoへlow、medium、highの優先度を追加する変更案を作らせました。
31.8秒後、マイグレーション、リポジトリ層、入力検証、UI、テストを含む7ファイルの提案が返りました。 使用量は入力6,885トークン、出力5,341トークン、合計12,226トークンです。
提案されたパスは許可範囲に収まり、ビルドも成功しました。
優先度を追加する前からあるTodoがマイグレーション後にmediumとなることも、モデルの外に置いた評価器で確認できました。
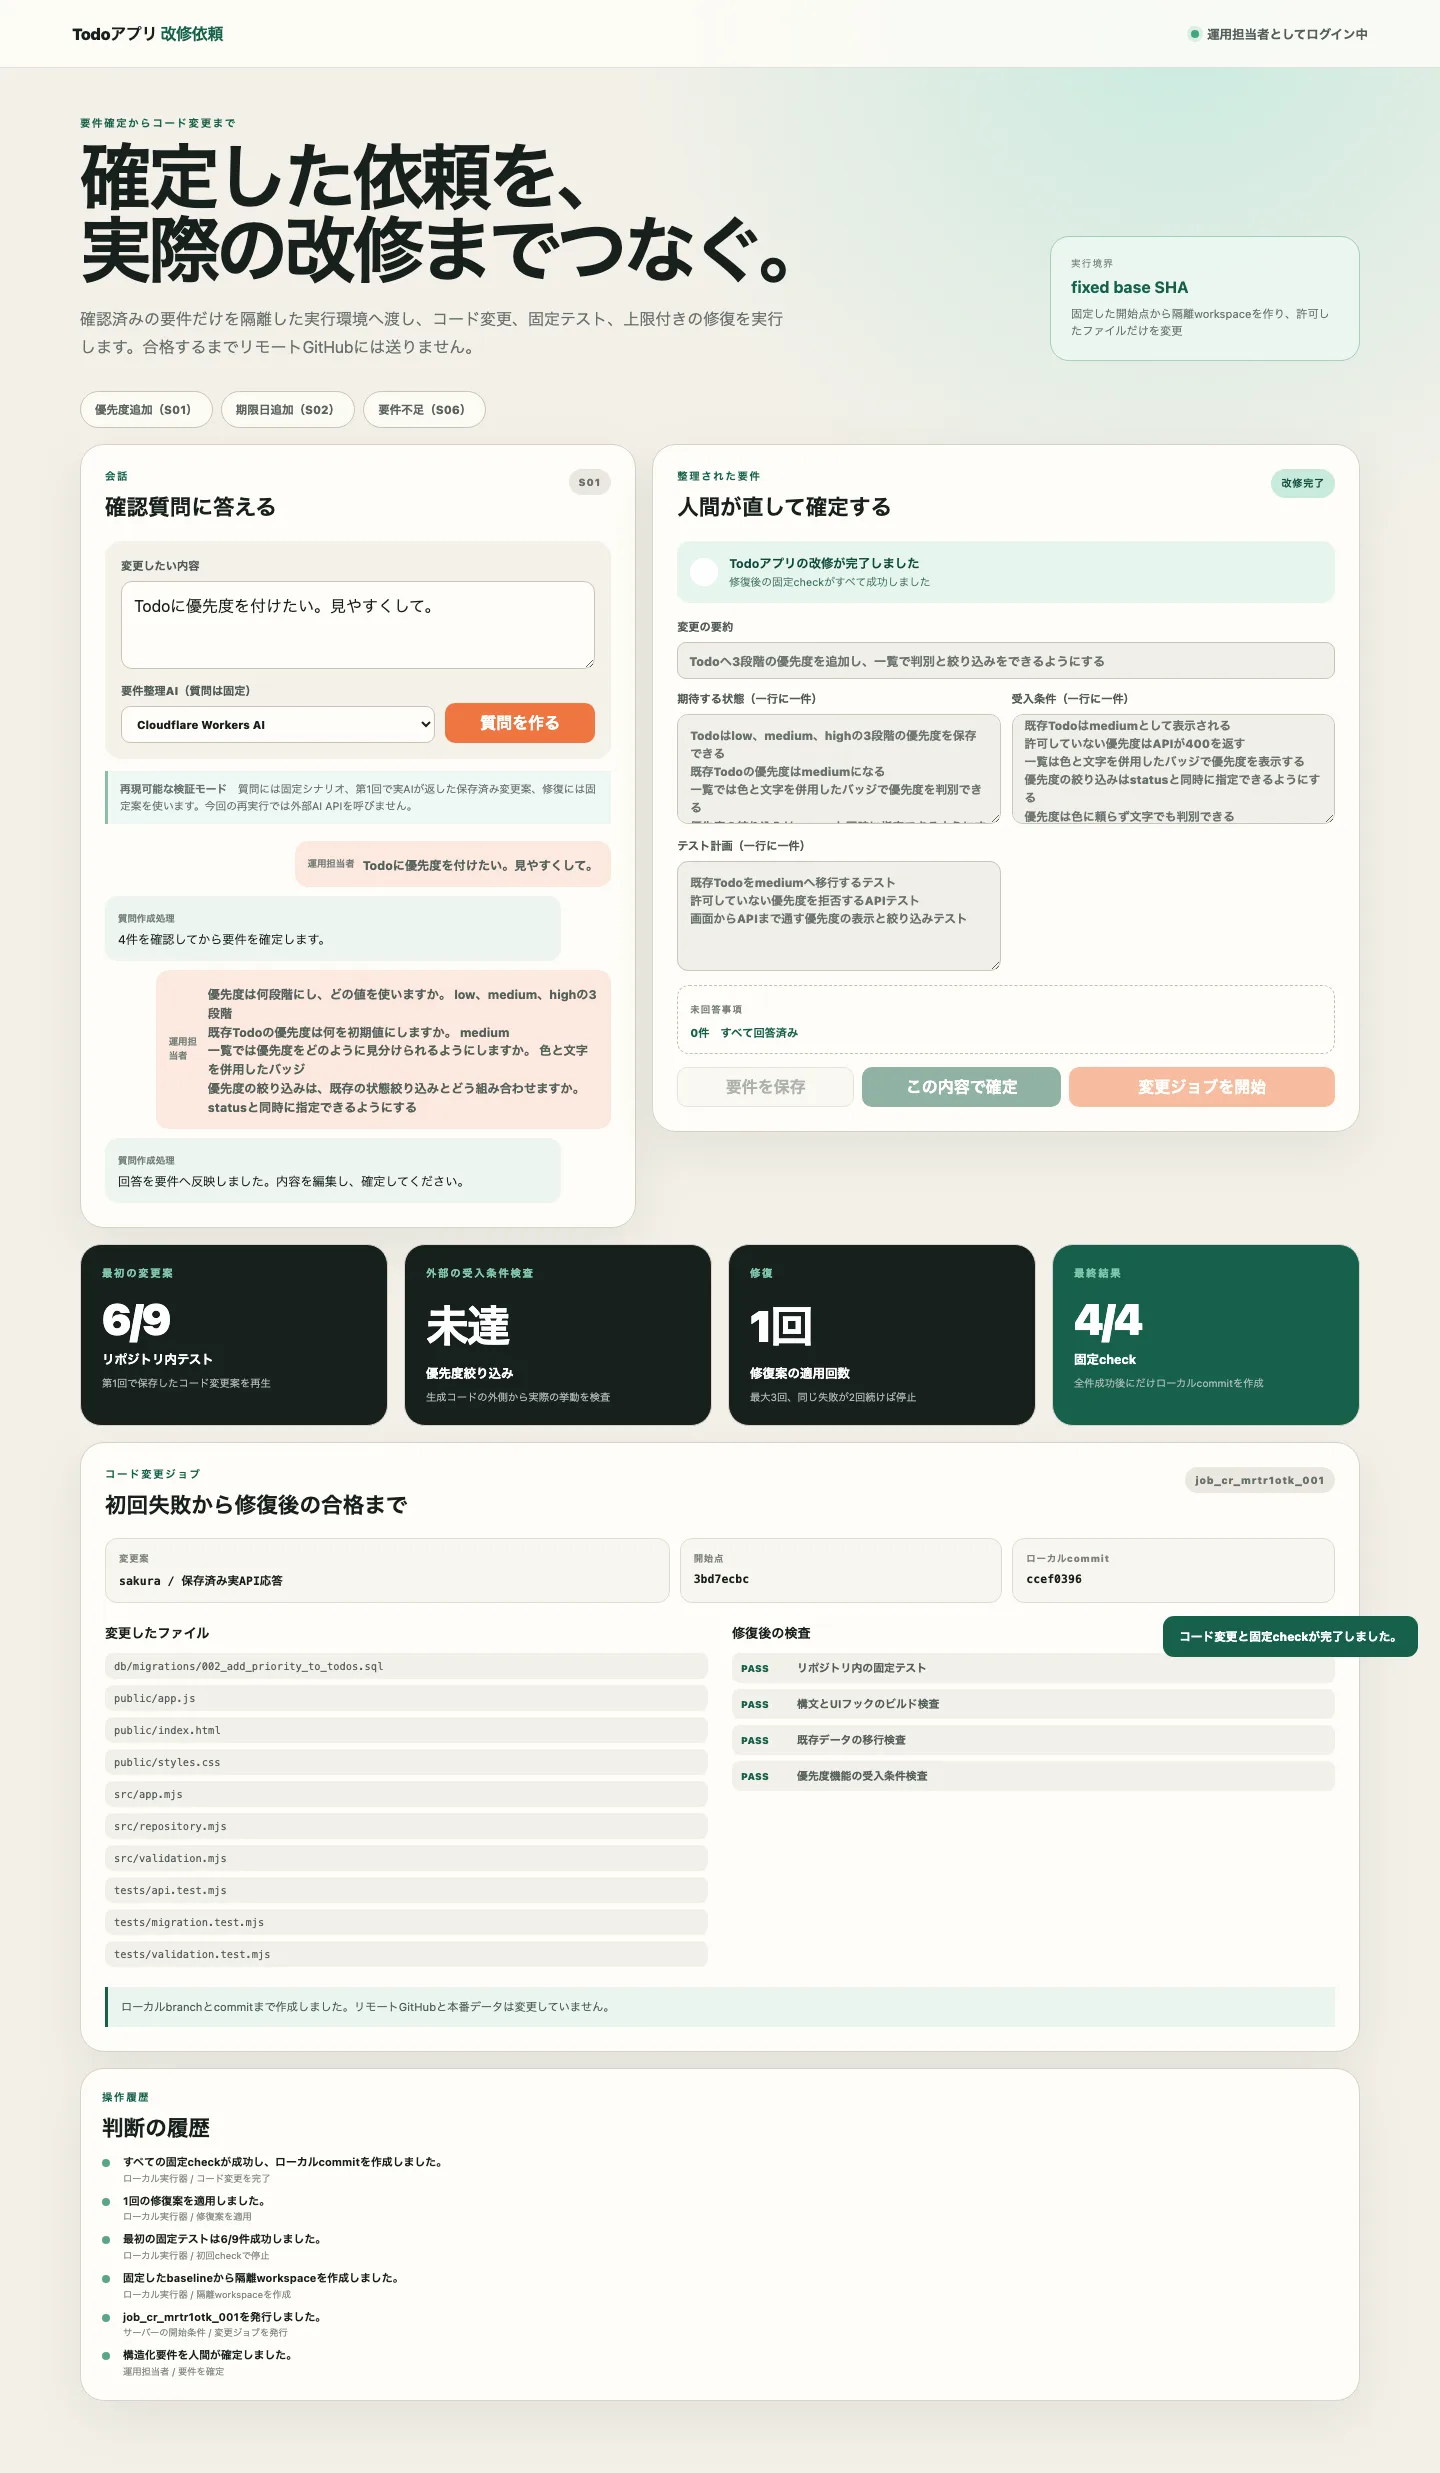
ここまでは順調でした。 固定テストを走らせたところ、9件中6件成功、3件失敗でした。
- ベースライン用テストが、すべてのマイグレーションを適用したあとにも優先度列のない旧スキーマを期待していた
- 優先度追加のテストが、検証対象の行を作らないまま、存在しない行の優先度を読んでいた
- 入力検証のテストが、新たに加わった既定の優先度を期待値へ含めていなかった
優先度を追加するコードはそろっていても、同時に生成されたテストが変更後の契約と噛み合っていません。
実行器はここで処理を止め、ローカルブランチ、コミット、Draft PR用のデータを作りませんでした。
冒頭のSTOPPEDは、この3件を見て出した結果です。
9件中3件が落ちているのにREADYと表示してしまえば、専用画面を作った意味が薄れます。
今回は失敗内容をモデルへ返す自動修復もまだ行わず、最初の提案をどこで止められるかまでを記録しました。
マイグレーション名の決め打ちを評価器から外す
ここで、検査側にもバグが見つかりました。
固定テストとは別に用意した外部評価器は、追加マイグレーションの名前を002_add_todo_priority.sqlへ固定していました。
モデルが返した名前は002_add_priority_to_todos.sqlです。
内容を読む前に、file not foundで落ちていました。
検査したいのはファイル名ではなく、002番のマイグレーションを適用したあとに既存Todoがmediumになるかどうかです。
そこで「002_*.sqlがちょうど1件ある」ことを確かめ、そのファイルを適用するように修正しました。
修正後は既存データの検証に成功しています。
検査が厳しくても、保証したい内容からずれていれば正しい変更まで落としてしまいます。 今回固定すべきだったのは、マイグレーションの順序と適用結果でした。
GitHubのコード変更とD1のデータ変更を分ける
「Todoを変更する」という言葉には、2種類の操作が混ざります。
優先度フィールドを追加するなら、データベースのスキーマやマイグレーションだけでなく、API、UI、テストまで変わります。 そのためGitHubでコードを直す経路へ進みます。 既存Todoを完了へ変えるだけなら、必要なのはD1のデータ更新です。
D1のデータ更新で許可した操作は、todo.set_statusとtodo.set_titleの二つです。
サーバーが引数を型検査してプレビューを返し、人間が確認したあとにプリペアドステートメントを実行します。
モデルが生成した未加工のSQLや任意のクエリは、契約テストで拒否しました。
この経路で接続したのはローカルSQLiteまでです。 本番D1は更新していません。 GitHub側も、検査成功後のローカルパッケージを作る処理までで、リモートブランチやDraft PRは未作成です。
画面には「Draft PR」や「D1」と表示されていますが、今回は外部へ書き込む一歩手前で止めています。 まず確認したかったのは、AIの提案が不完全なときに、GitHubと本番D1を巻き込まずに済むかどうかでした。
3社の切り替えと安全停止を評価する
専用Web画面から、さくら、Cloudflare、Googleの実APIを切り替え、同じ形式の要件JSONを受け取るところまでは動きました。 AIプロバイダを替えても、許可パス、固定テスト、GitHubとD1の権限境界はそのままです。
コード変更では、さくらがマイグレーションからUIまで7ファイルを返し、ビルドと既存データのマイグレーション検証を通過しました。
それでも固定テストは3件落ち、画面はSTOPPEDを表示しています。
GitHub上のリポジトリと本番D1は変わっていません。
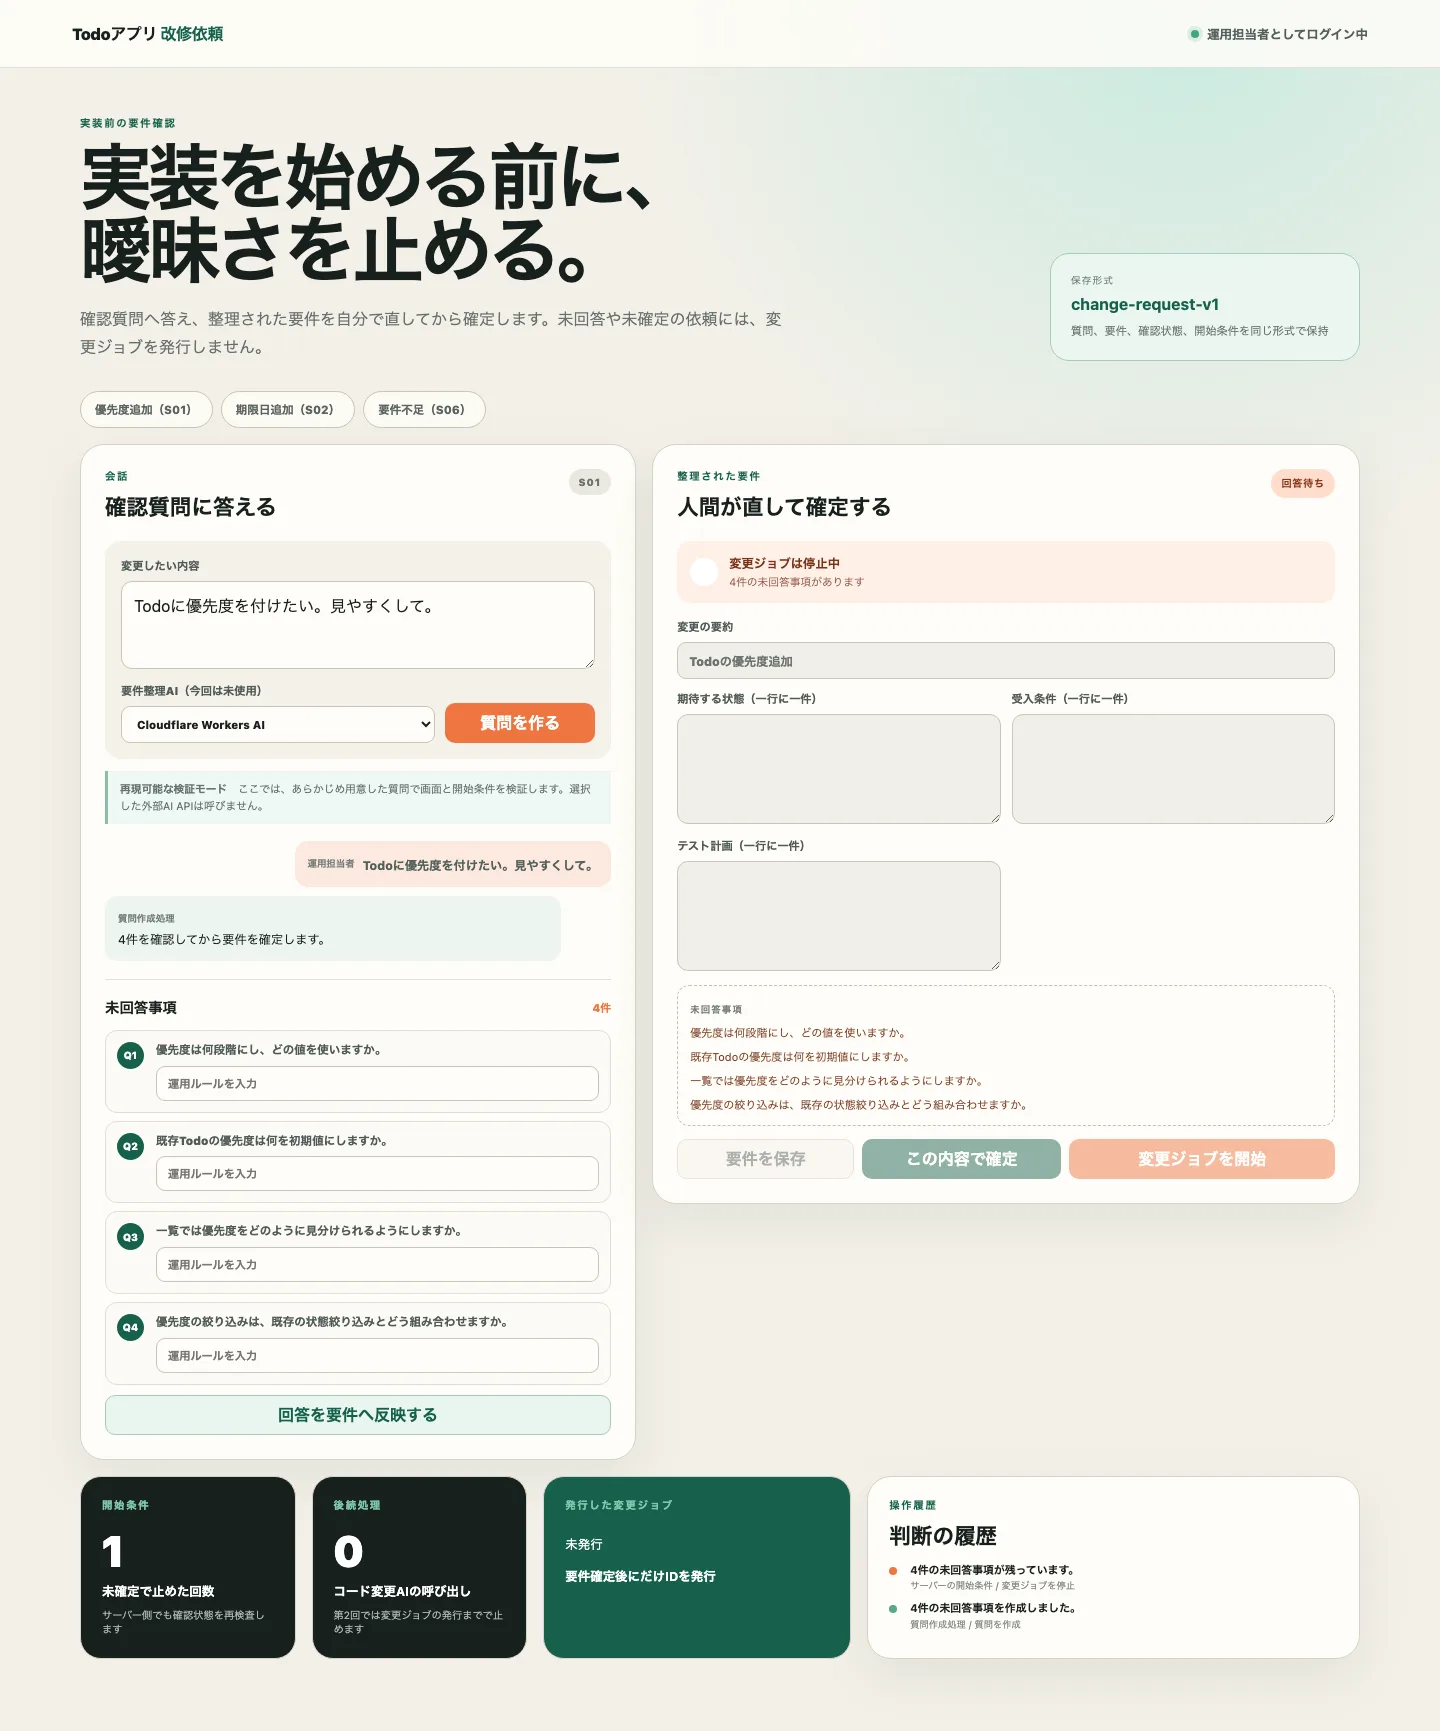
この結果から、第1回の判断は**Conditional Go(条件付きで継続)**です。 3社の応答を共通形式へそろえ、固定テストの失敗時に外部への書き込みを止める土台は機能しました。 非エンジニアがチャットで要件を確定し、実際のアプリ改修を完了する体験は、まだ検証できていません。
残っているのは、「見やすくして」のような曖昧な言葉を、誰がどこで確定するのかという問題です。 第2回では、AIからの確認質問に画面上で答え、利用者が要件を編集、確定したあとにだけ変更ジョブを始める流れを試します。