Tag
#agent
SWE-1.7の自己圧縮から考えるAIDDの再開メモ設計
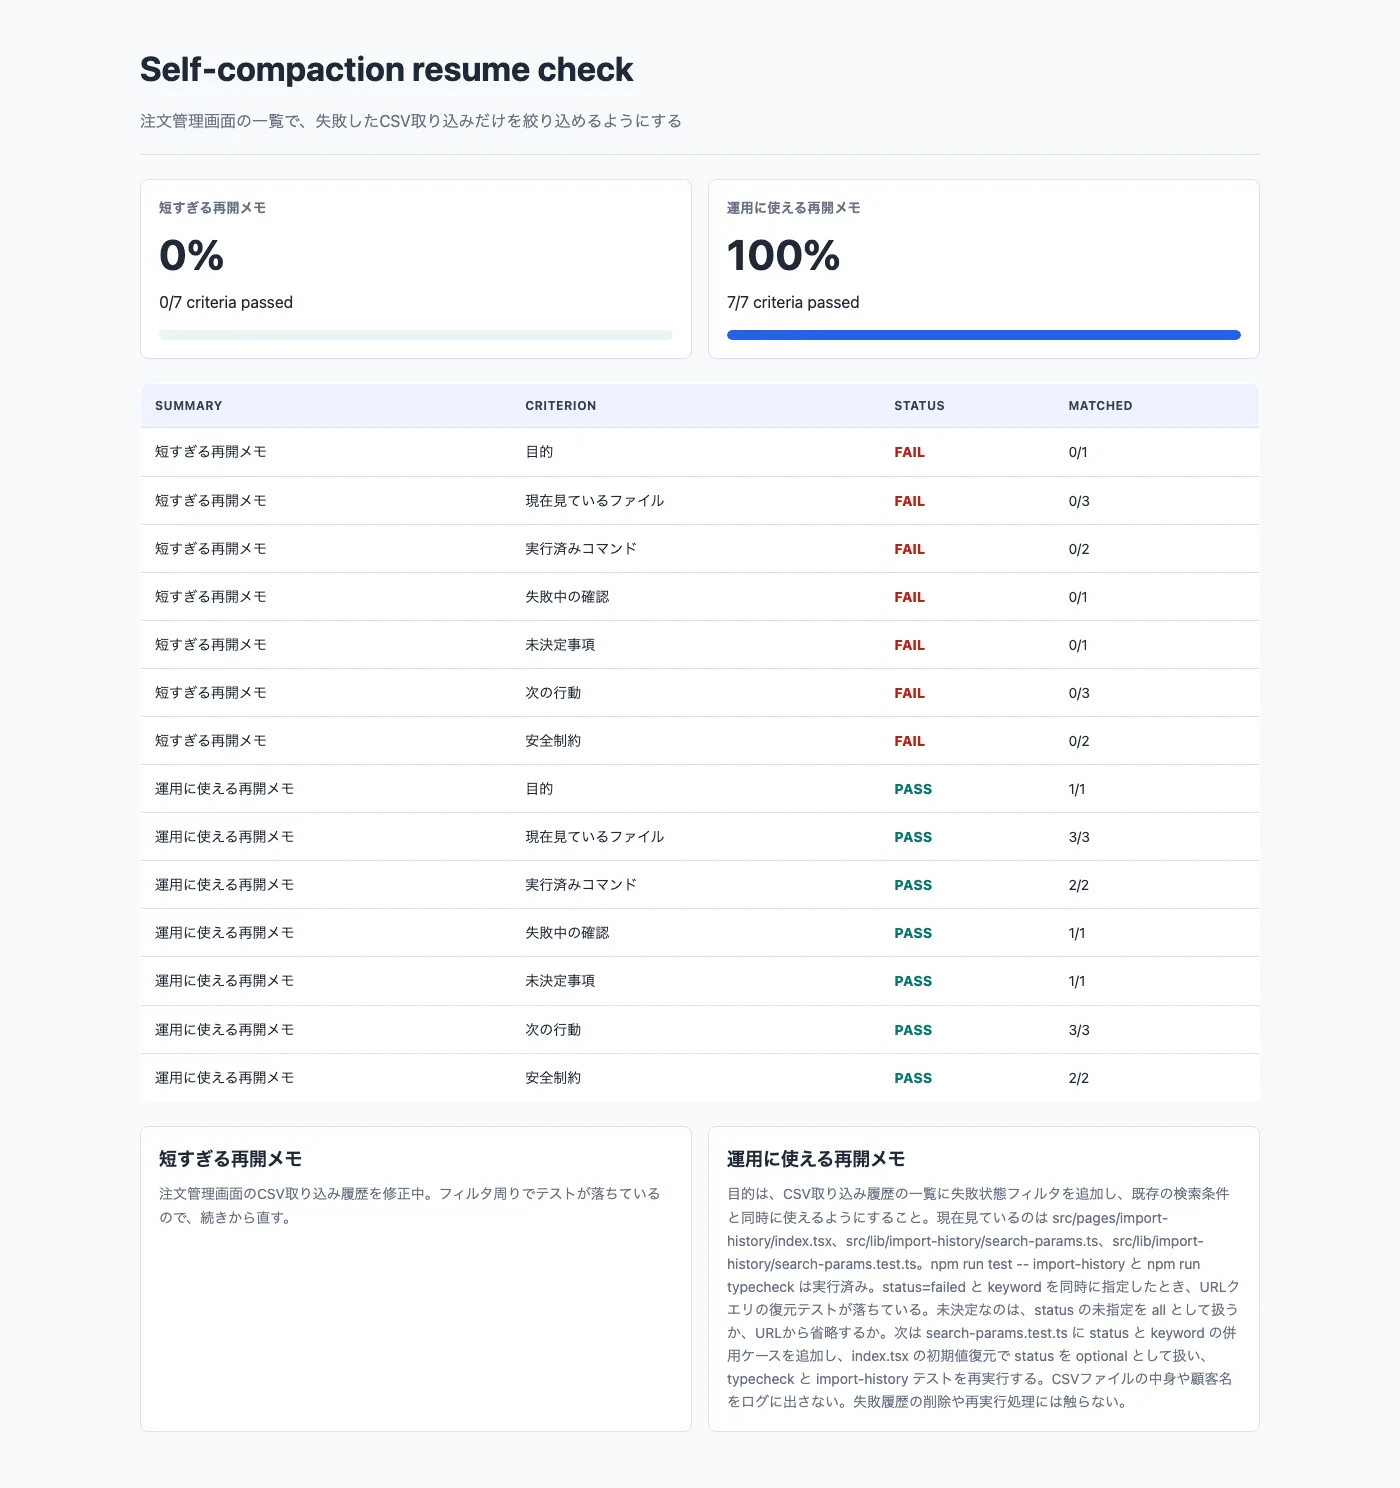
CognitionのSWE-1.7記事をきっかけに、長時間化するAI駆動開発で作業を再開できるメモには何が必要かを、外部APIに依存しない検証スクリプトで確認しました。
FlueのAgentはどこで失敗するのか Skill実行と構造化出力を切り分ける
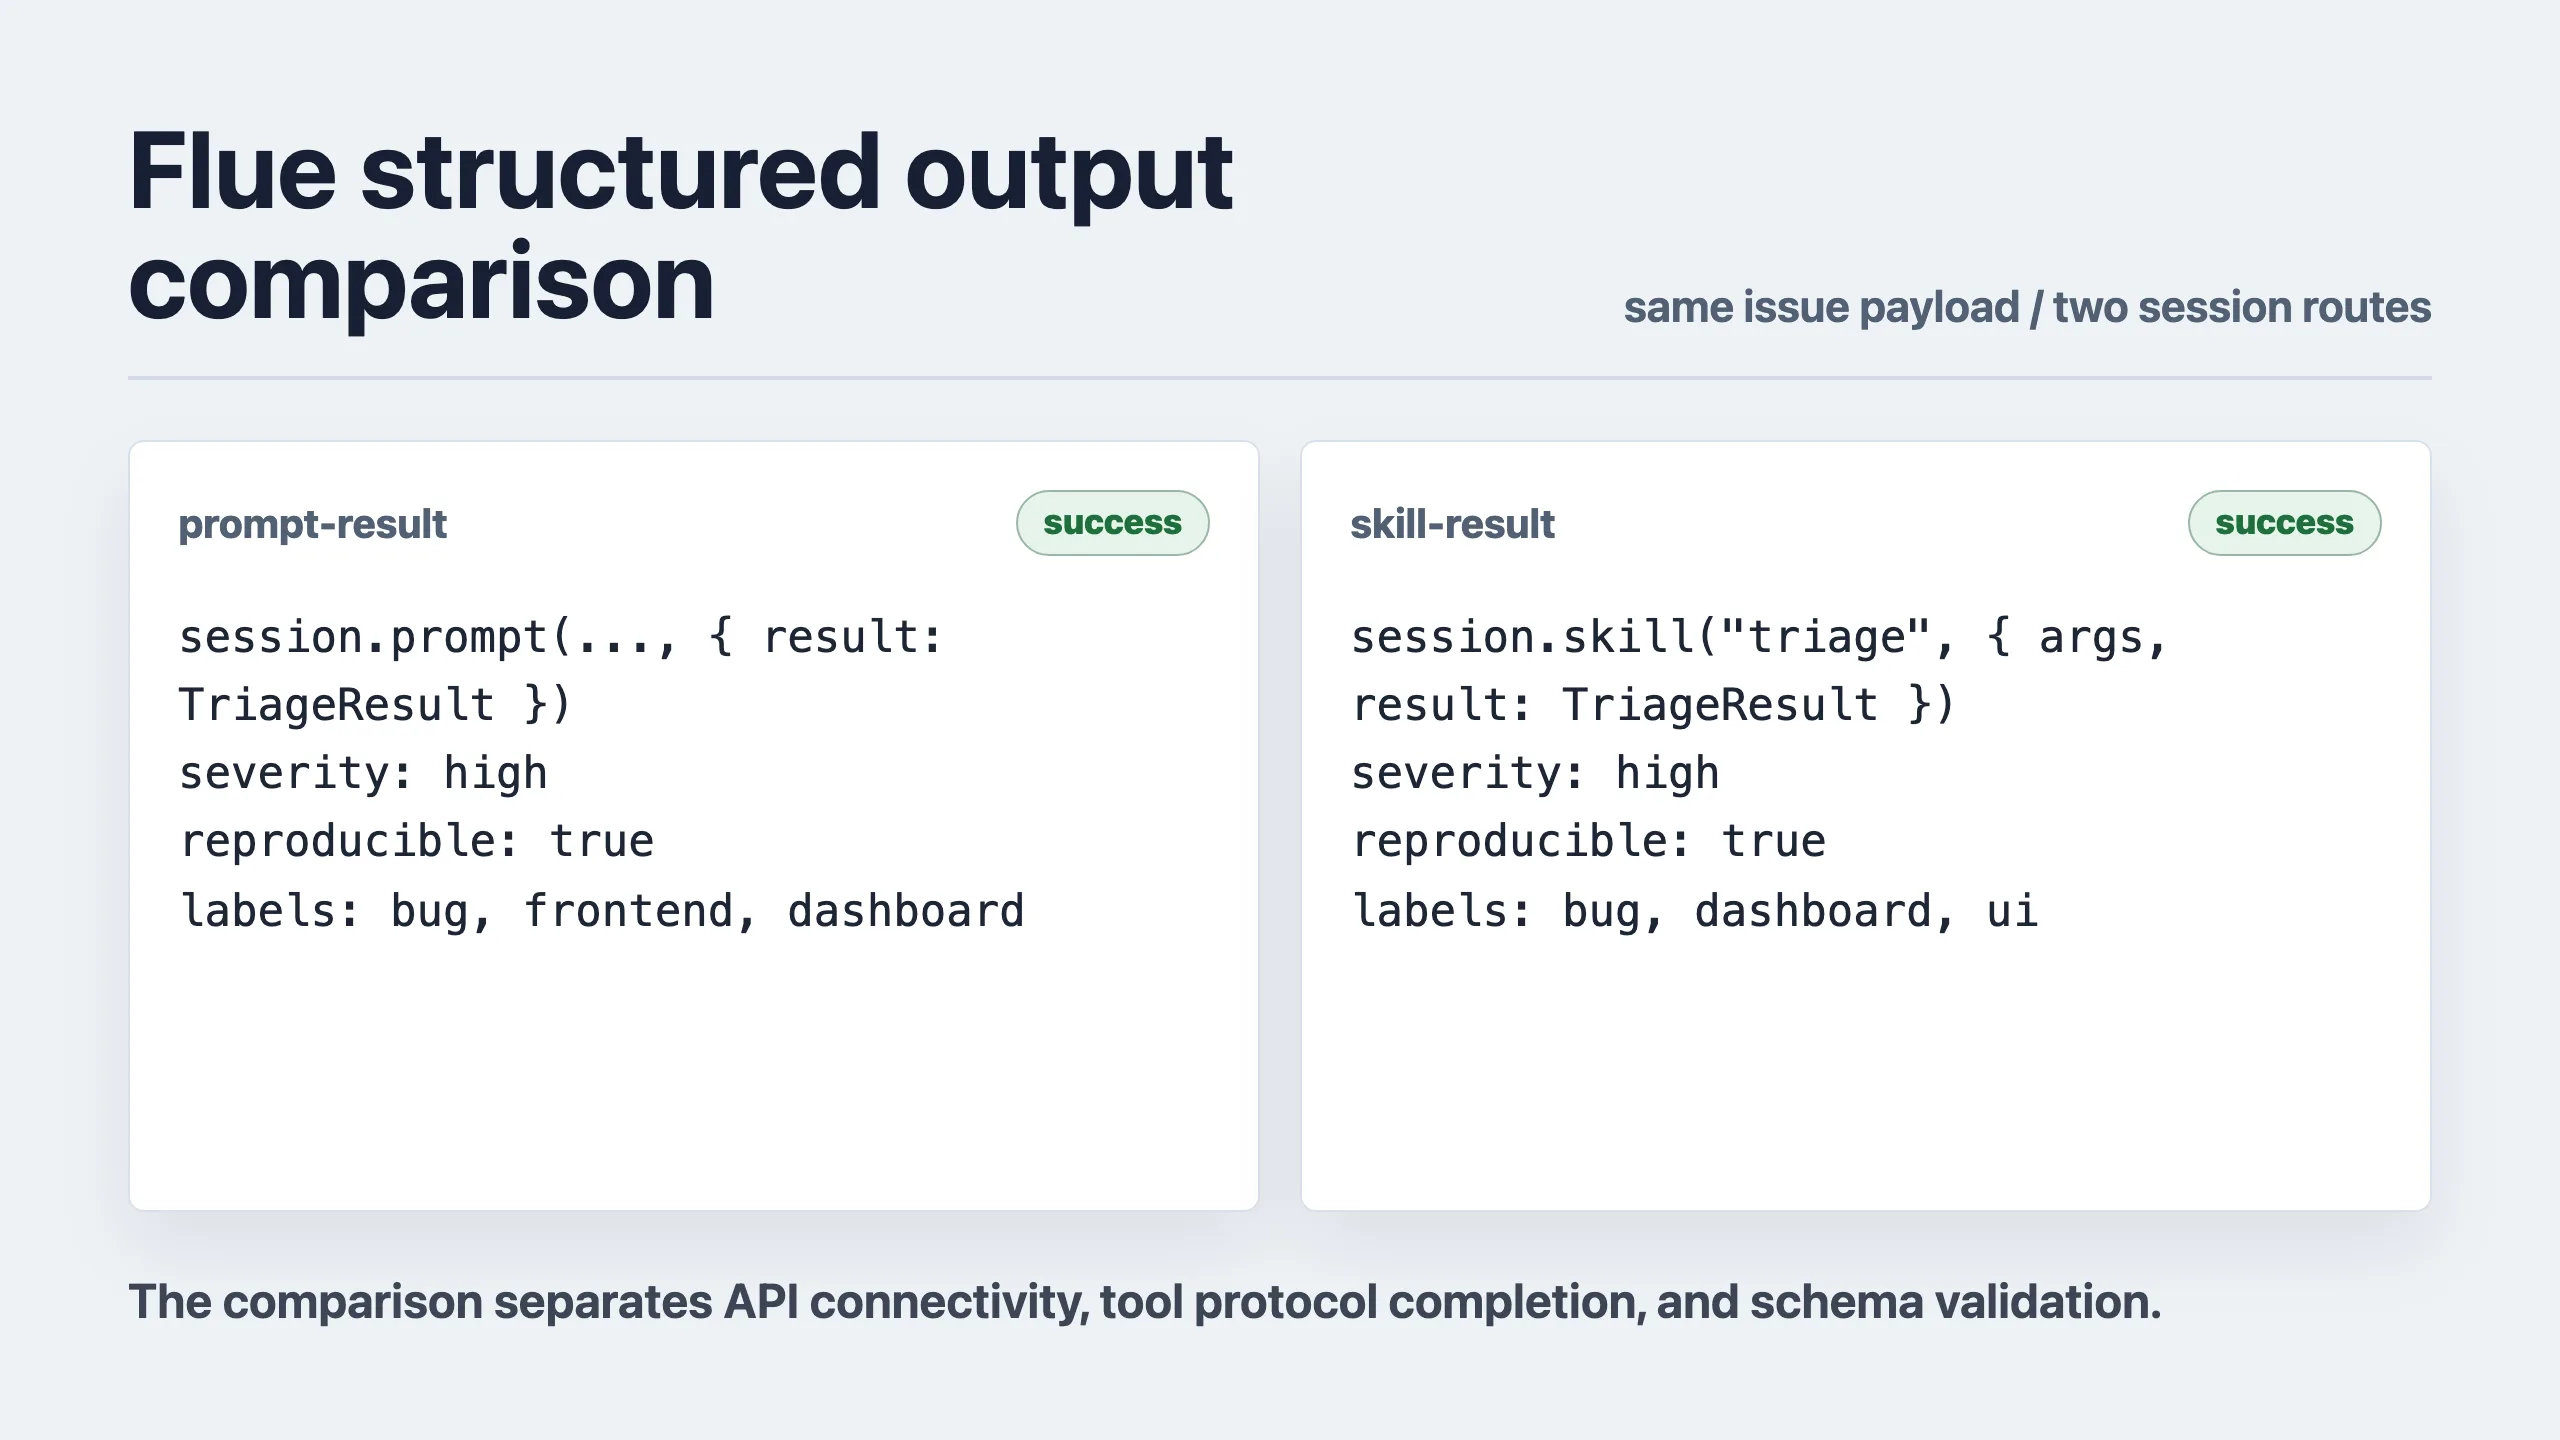
Flue 1.0 BetaのIssueトリアージAgentで、通常の指示とSkillの明示実行を同じ入力で比べ、finish到達、schema検証、分類品質を分けて確認した検証メモ。
Eveのeval失敗ログをLangfuse Datasetに残して評価条件を改善する
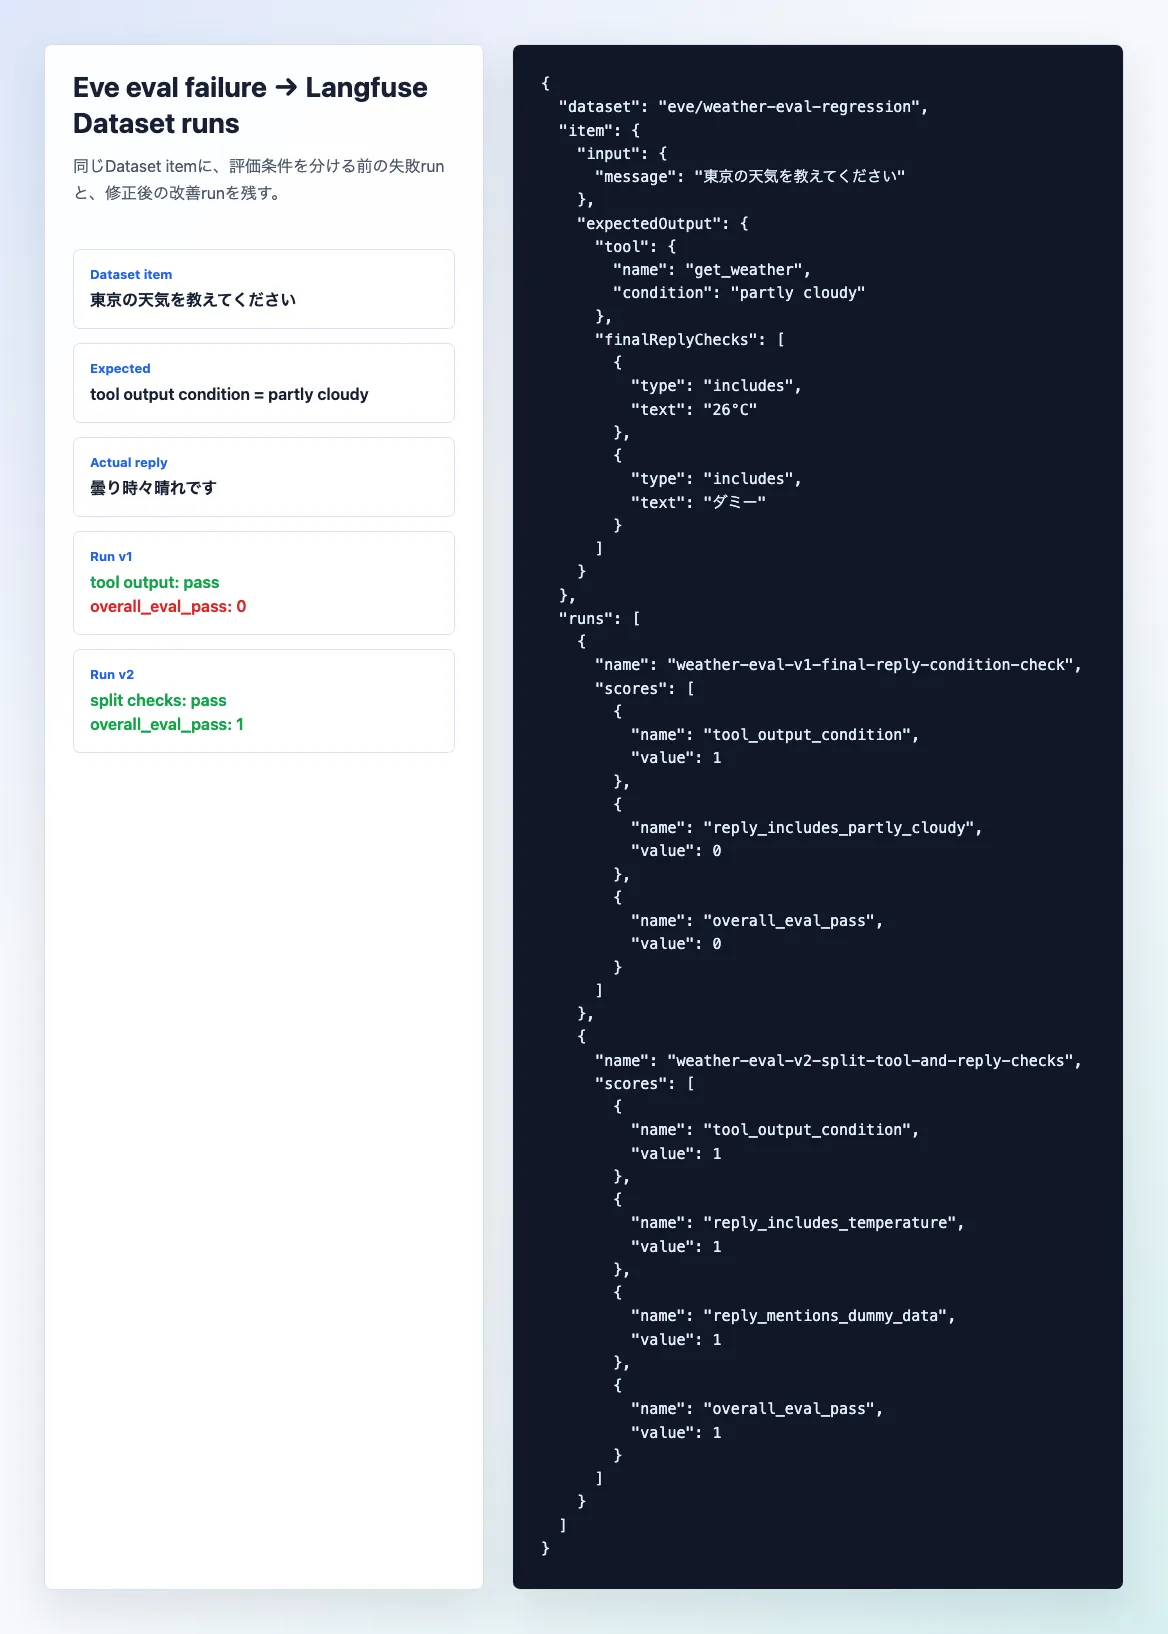
Eveの評価で一度落ちた天気ツールの失敗ログをLangfuse Datasetに登録し、失敗runと修正後runを比較しながら評価条件を改善する検証ログ。
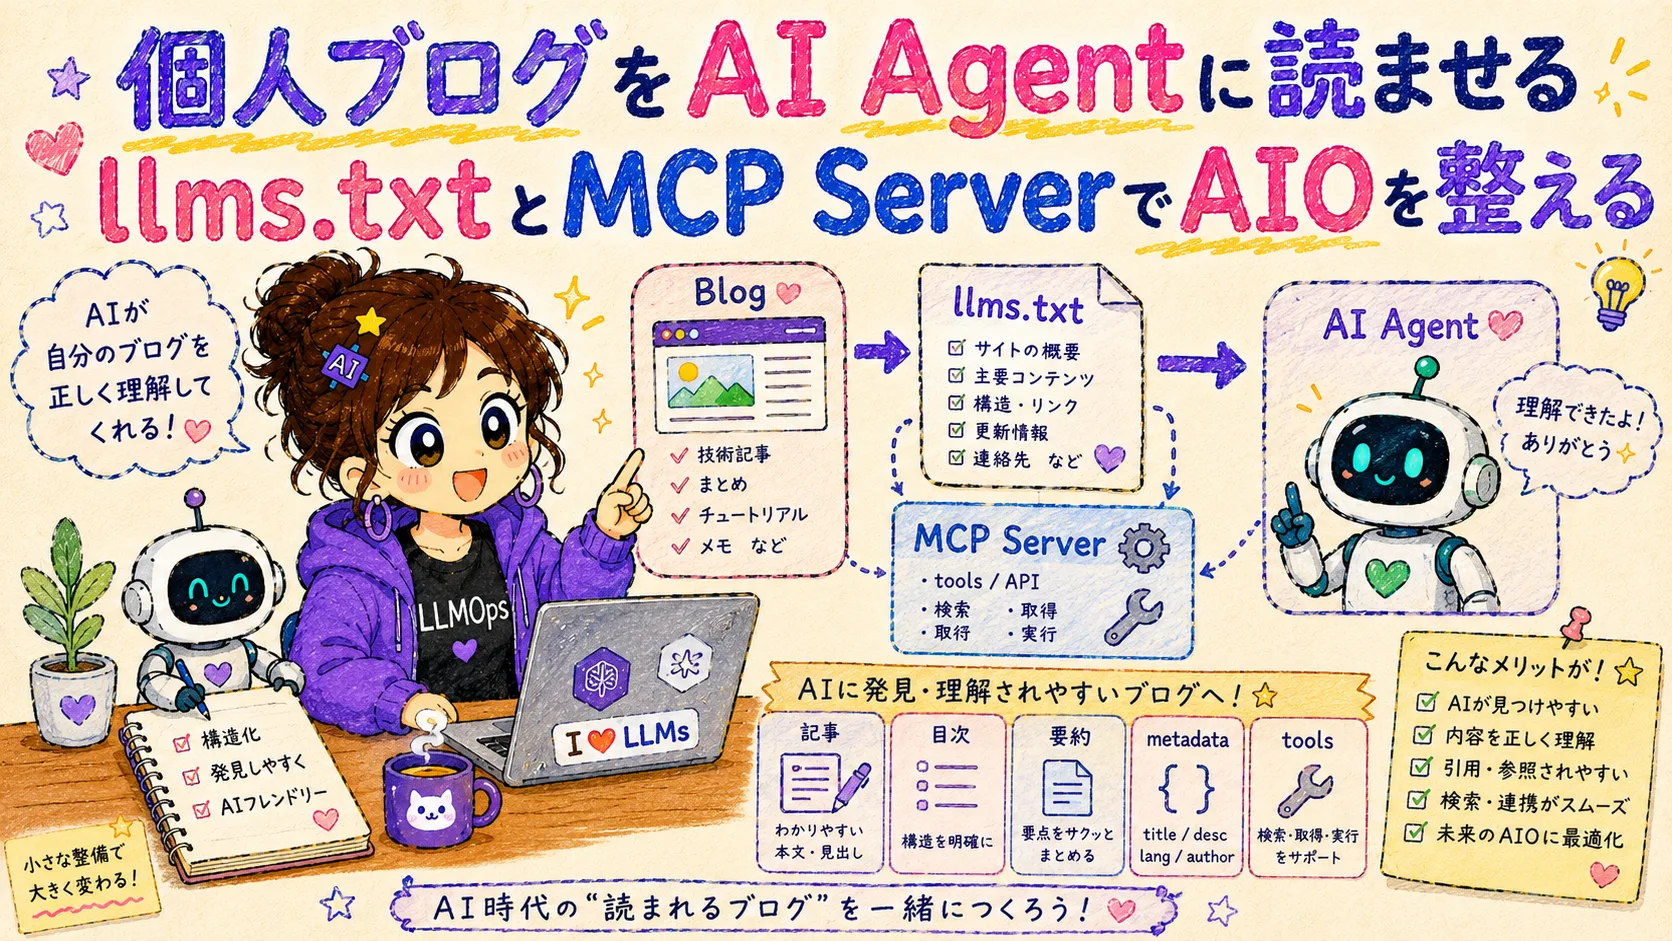
個人ブログをAI Agentに読ませる llms.txtとMCP ServerでAIOを整える
PerplexityやChatGPTが検索の代わりになる中、個人ブログをAI Agentからも発見可能にするAIO(AI最適化)の実装。llms.txt、JSON API、MCP Serverの3層設計と、46本規模での採用判断基準。

FlueでOpenAI互換APIを使うときはmodel specifierを先に疑う
Flue 1.0 BetaでOpenAI互換APIを使う際に、実モデルIDとFlueのprovider-id/model-id形式を混同してUnknown model specifierで止まった検証メモ。
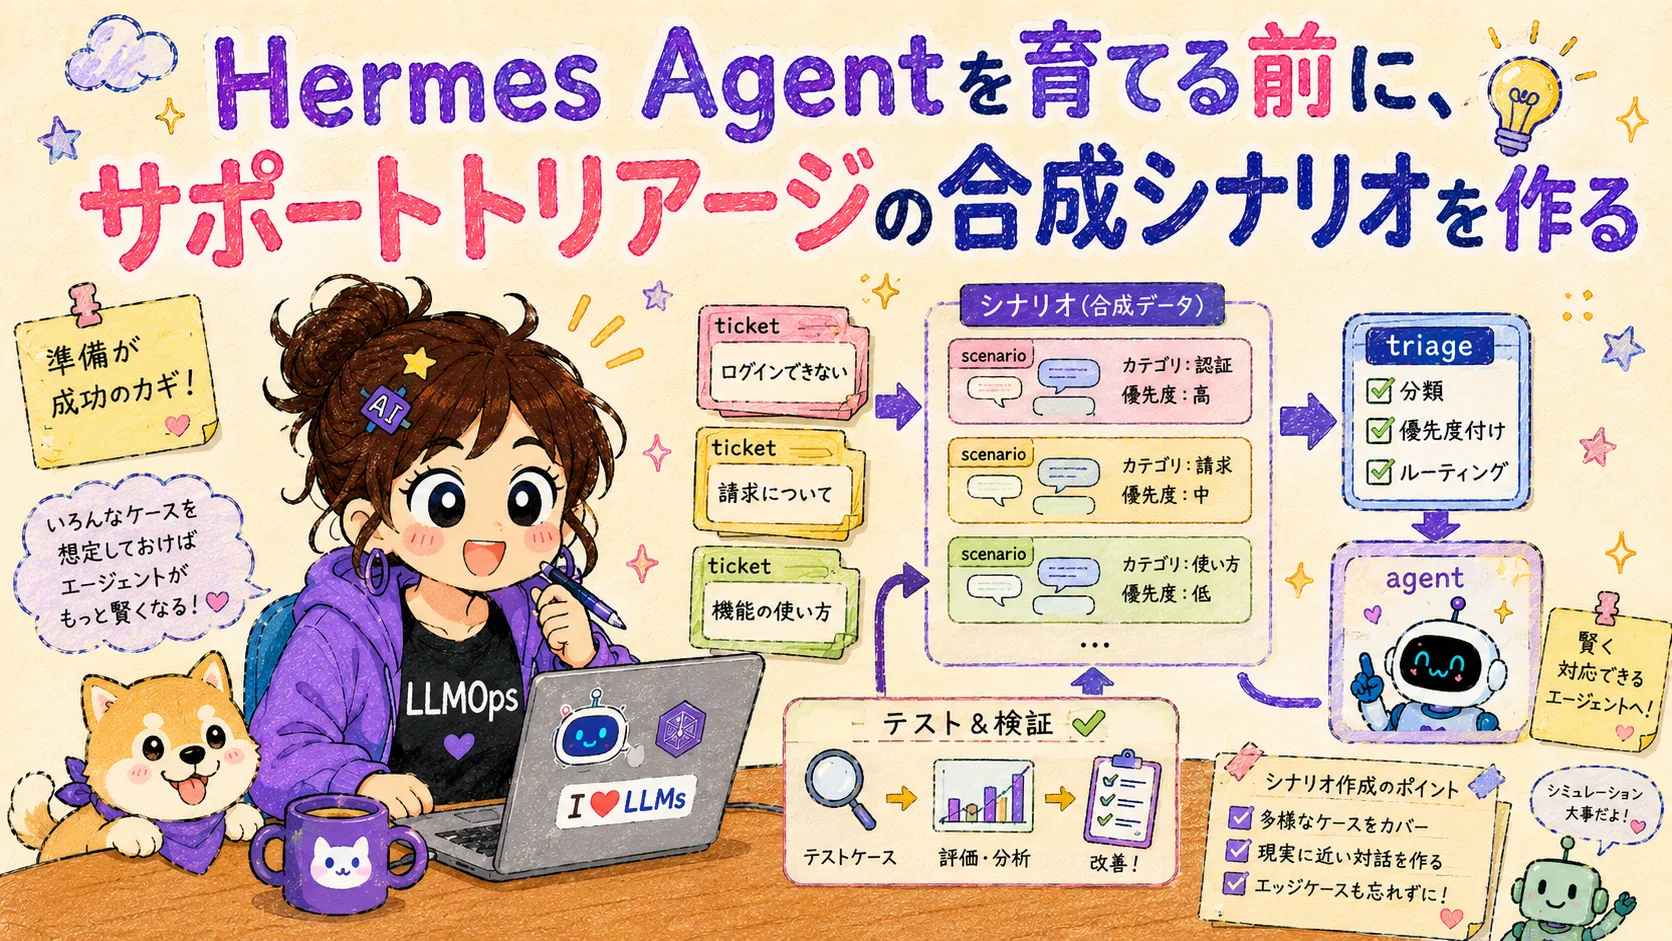
Hermes Agentを育てる前に、サポートトリアージの合成シナリオを作る
Hermes Agentにサポートトリアージを任せる前段階として、実データを使わずに評価可能な3本の合成シナリオを作り、判断根拠と安全制約を先に固定する。
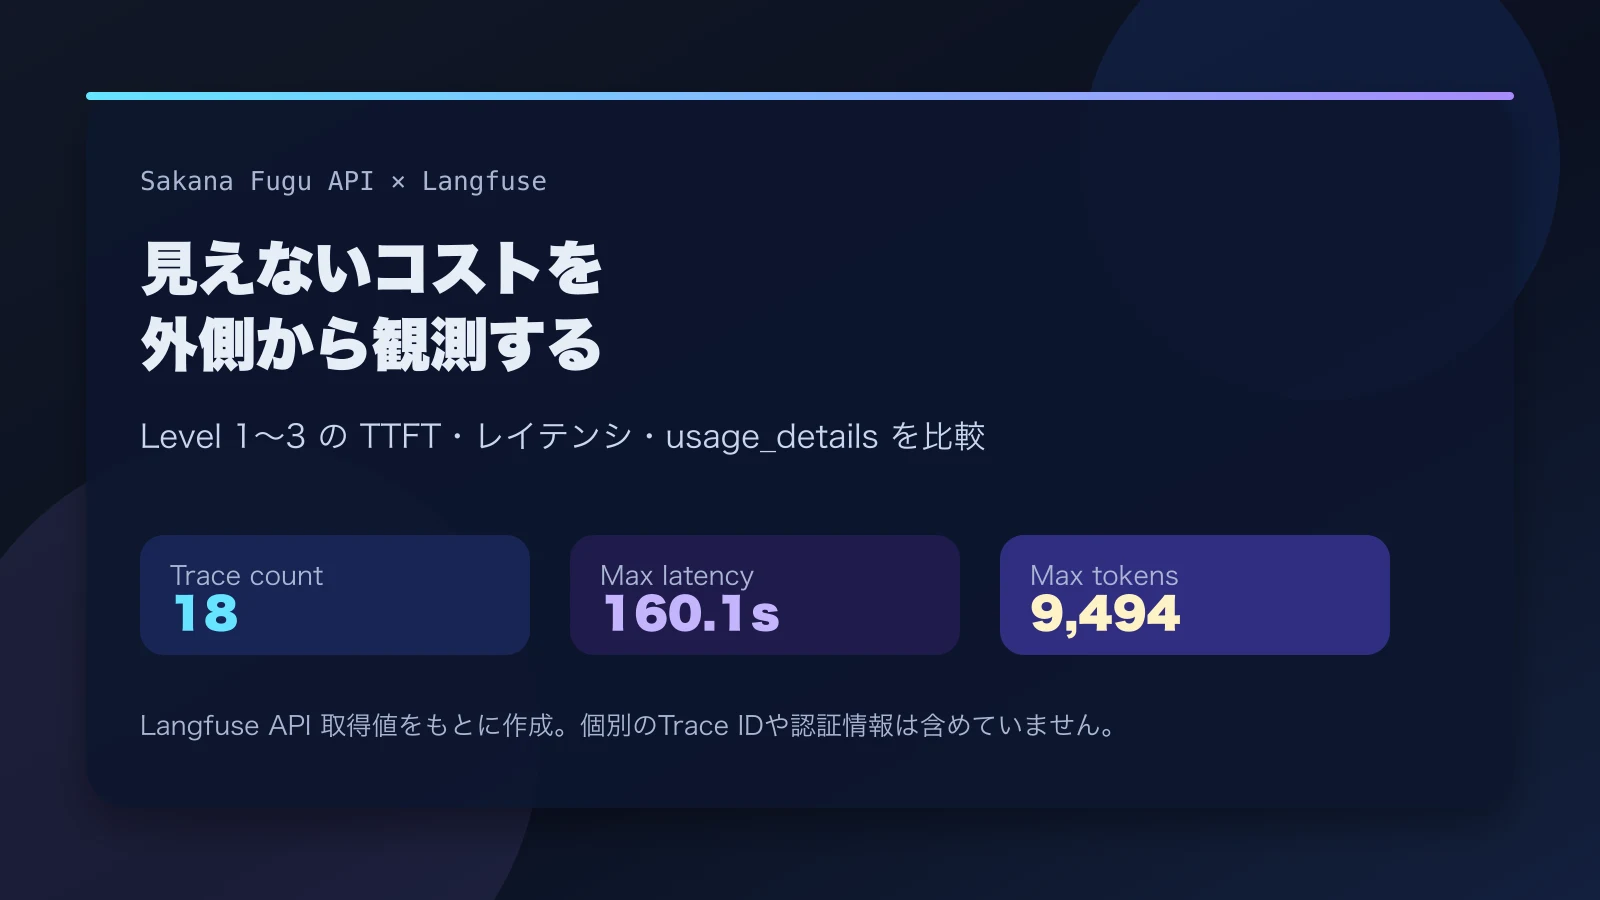
Sakana Fugu APIをLangfuseで観測し、マルチエージェントの見えないコストを考える
Sakana FuguのOpenAI互換APIをLangfuseで計装し、Level 1〜3のタスクでレイテンシ、消費トークン、TTFTがどう変化するかを観測した実践レポート。
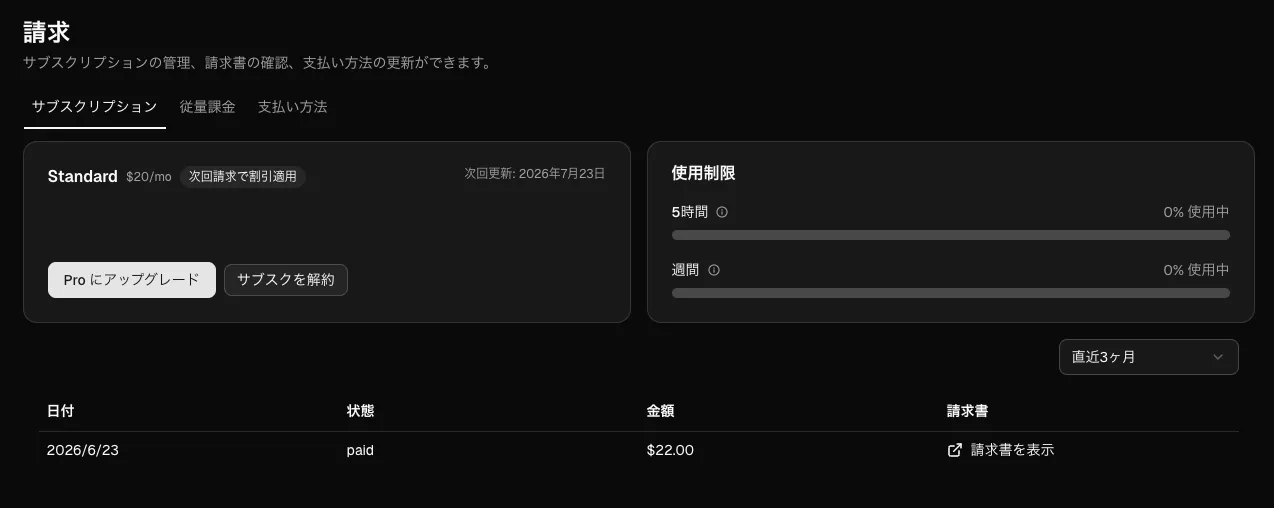
Sakana Fuguを契約したので、マルチエージェントAPIの見えなさをLangfuseで観測する
Sakana Fuguをサブスク契約して分かったOpenAI互換APIとしての性質と、ブラックボックスな協調推論を外側から観測するための検証計画。
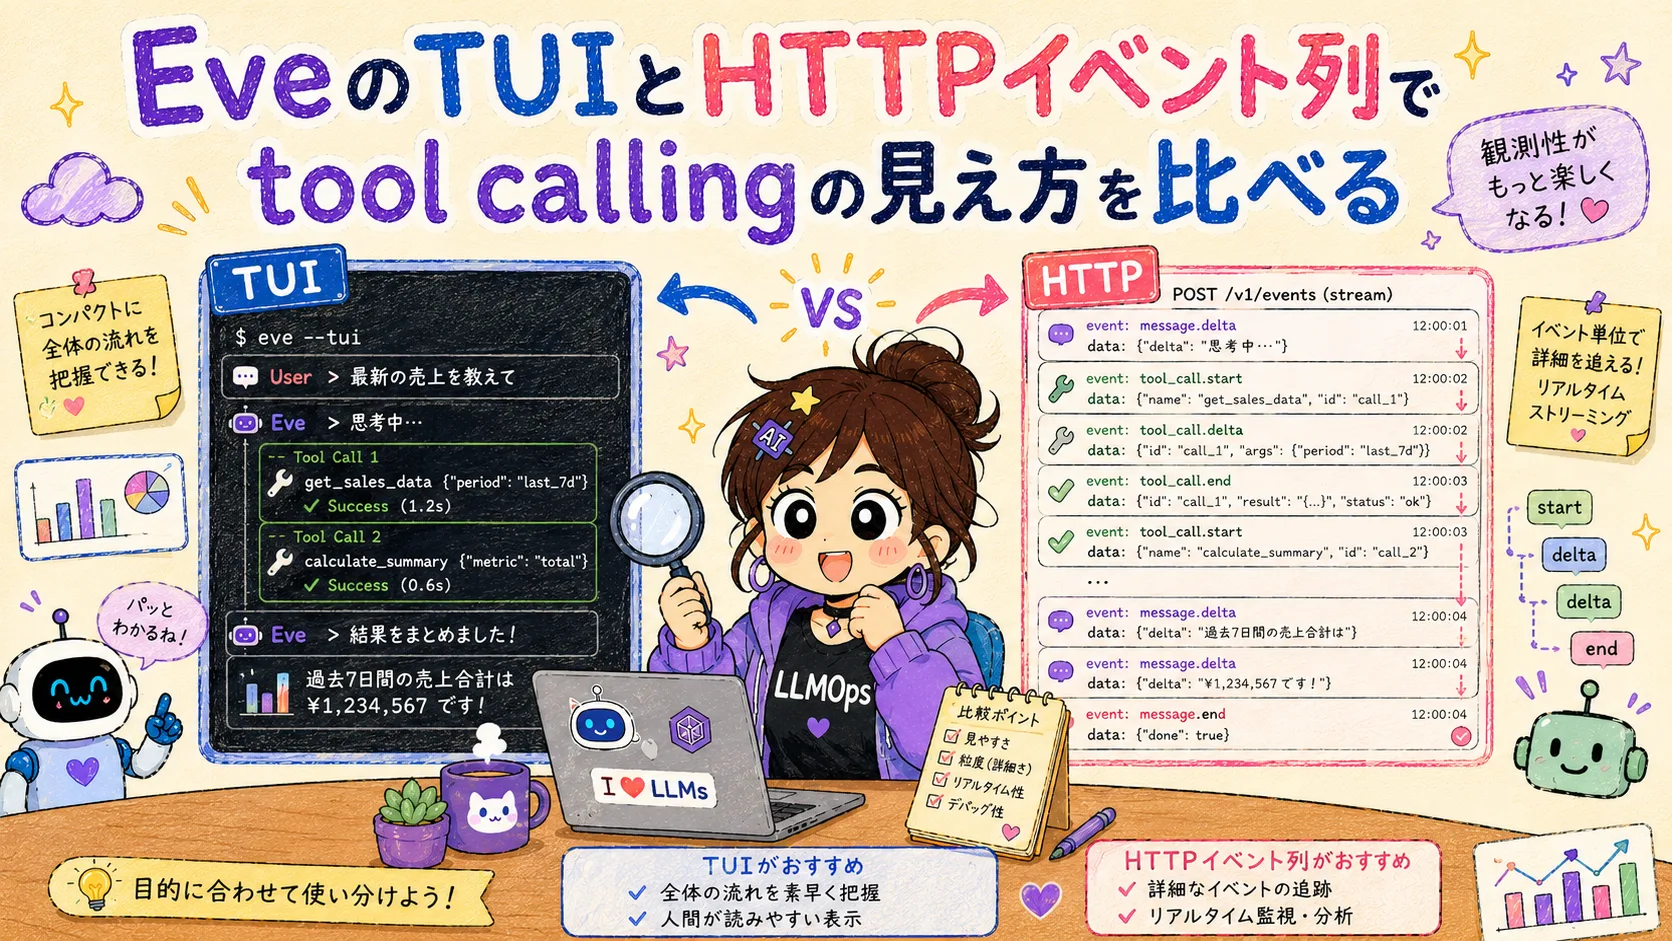
EveのTUIとHTTPイベント列でtool callingの見え方を比べる
VercelのエージェントフレームワークEveで同じ天気ツール呼び出しをTUIとHTTP APIから観測し、開発者向け表示と外部連携向けイベント列の違いを整理した検証ログ。
FlueのobserveイベントをLangfuseへ流し、IssueトリアージAgentを観測する
Flue 1.0 BetaのobserveイベントをredactionしたうえでLangfuseへ送信し、IssueトリアージWorkflowのrunId、モデル、結果を追う実験ログ。
EveのTUI実行とtool callingをLangfuseで観測する
Vercelのエージェントフレームワークeveで動かしたtool calling実行を、Langfuseへtrace/span/generationとして送る方法を2パターン試して比較したログ。